
Proxmox VE
Это содержимое пока не доступно на вашем языке.
虚拟机管理程序:具有守护进程和网络的节点、虚拟机、容器、存储、LVM 精简池、备份、高可用性、快照、复制、Ceph 到 OSD、物理磁盘和 ZFS 池、待处理更新、包变更、订阅和证书。一个监控项可以覆盖整个集群。
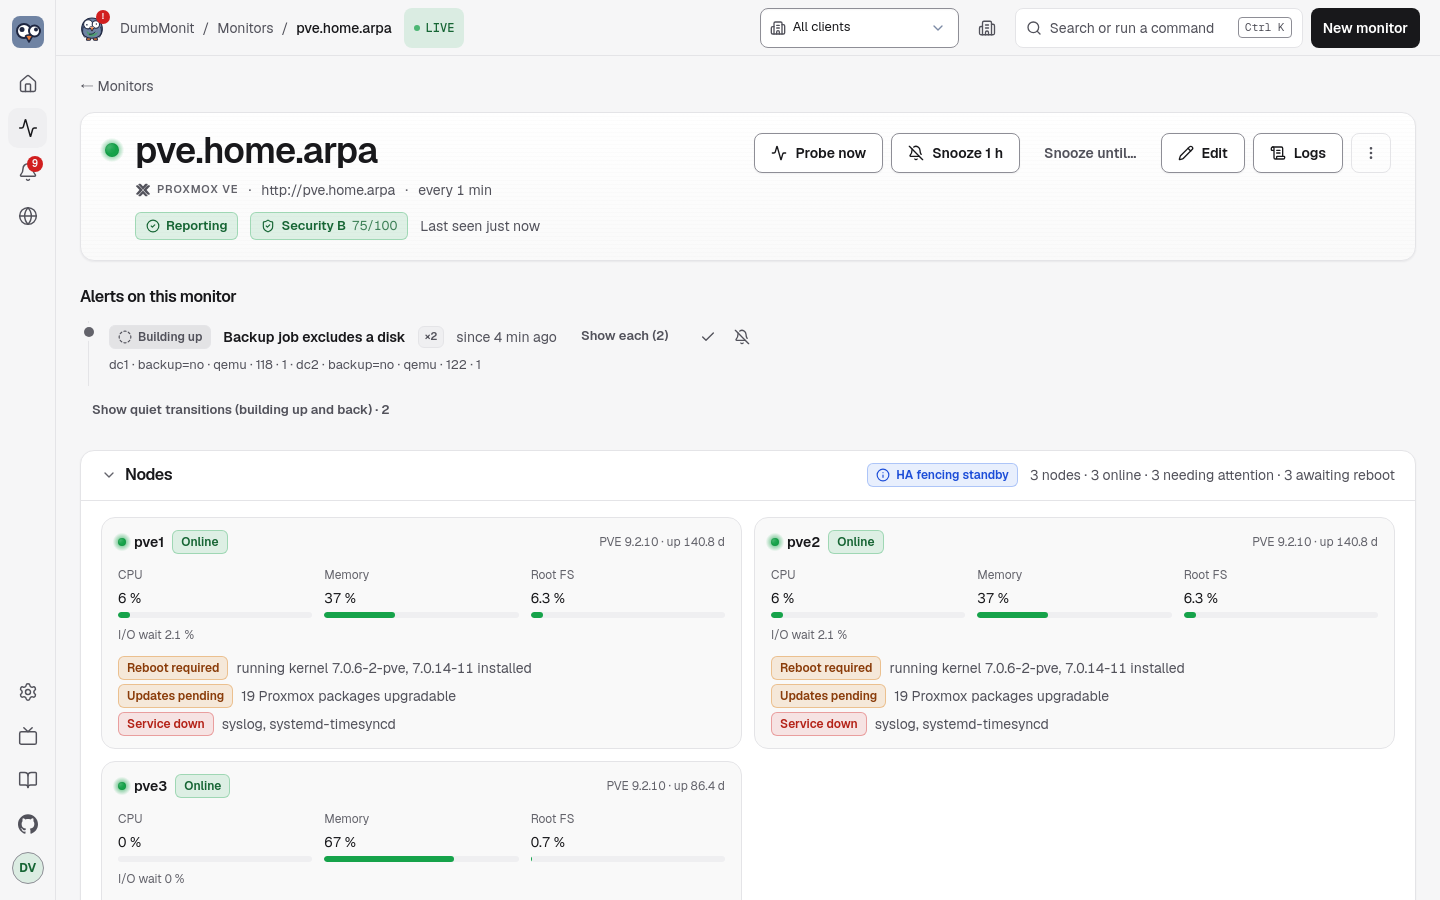
监控项页面在一张卡片上打开,每个节点:CPU、内存和根文件系统作为三个仪表、正常运行时间和该节点上安装的 pve-manager 版本,然后仅是出错的地方 — 未运行的守护进程、在启动时声明但未启动的接口 — 以及每个 LVM 精简池和卷组的填充。停止响应的节点保持其卡片并读取 offline。
两行在仪表下,当节点报告它们时:CPU 时间的份额花在存储等待上(I/O 等待 — 一个 CPU 为 10% 且 I/O 等待为 30% 的节点没有余地,没有其他数字说明)以及内存 KSM 通过在客户之间共享相同页面回收的,这是节点如何托管超过其 RAM 的方式。
两个更多的条目加入”什么是错误的”列表,两个都是文字:
- 需要重启 — 安装了比运行的更新的内核。卡片命名两个版本,因为节点保持运行旧的直到重启。这来自
/nodes/{node}/apt/versions,仅需要Sys.Audit; - 更新待处理 — 有更新候选版本的 Proxmox 包数,来自同一调用。它与
apt/update不同,它计数系统的每个待处理包但需要Sys.Modify并通常被拒绝。
当集群报告 HA 看门狗(Proxmox VE 9 及更高版本)时,其状态在面板标题旁述状:HA fencing armed 一旦资源交给 HA,HA fencing standby 在没有资源时 — 在这种情况下,没有节点会被隔离,这是正常的但值得在计数之前知道。
逐节点升级的集群显示它在这里:/version 回答被询问的节点,所以每张卡片携带自己的版本,一个落后者是可见的而不需要打开 shell。
数据来自 GET /api/targets/{id}/proxmox/nodes,从指标存储中的最后一个探针读取。
在节点下,Guests 面板:每个虚拟机和容器一行,按节点分组,回答管理员首先提出的问题 — 它在运行吗,它忙吗,它的磁盘满吗,它最后备份是什么时候。每行显示:
| 列 | 来源 | 注释 |
|---|---|---|
| 状态 | 词加板:running、stopped、paused、suspended、template | 模板被列出但从不计为”已停止”。 |
| 名称、VMID、节点 | 库存 | |
| CPU | guest_cpu_percent,分配给客户的内核中 | 一个条加核心数。 |
| 内存 | guest_memory_used_bytes / guest_memory_total_bytes | VM 有时的气球大小。第二行,+N on host,出现在 guest_memory_host_bytes 有意义地高于客户看到的内容时:QEMU 进程在虚拟机管理程序上花费的成本超过它交出的内存,这个盈余是模拟开销。低于 64 MiB 或 5% 线留出。 |
| 磁盘 | guest_disk_used_bytes / guest_disk_total_bytes | 容器:实际使用。VM:总是大小;使用仅当 QEMU 客户代理回答时(见下文),否则”仅大小”。 |
| 网络 | rate(guest_network_in/out_bytes) 在最后的探针上 | |
| 正常运行时间 | guest_uptime_seconds | |
| 最后备份 | backup_last_age_seconds | 当不知道备份时为空。 |
| HA | ha_resource_state_info | 仅适用于高可用性下的客户。 |
| 锁 | guest_locked | 一个徽章,仅在持有锁时(backup、migrate、snapshot…)。 |
列表按任何列排序,按节点、状态或池过滤,每个节点组折叠。单击一行在页面的时间范围内打开其 CPU 和内存,以及从客户内部看到的操作系统和 IP 地址。数据来自 GET /api/targets/{id}/proxmox/guests,从指标存储中的最后一个探针读取 — 虚拟机管理程序没有被要求任何东西。
锁在备份、迁移或快照需要的几分钟内是正常的。由中断作业留下,它阻止对该客户的每个操作 — 包括下一夜的备份 — 直到 qm unlock(或 pct unlock)清除它,这是为什么”客户锁定”在六小时后触发。
库存来自 /cluster/resources,集群自己的缓存,所以停止响应的节点的客户仍然被列出 — 状态为 unknown 和它们的大小,没有活测量 — 而不是在您想看到它们的时刻消失。它也花费每个节点少两个 API 调用比走过 /nodes/{node}/qemu 和 /nodes/{node}/lxc,这是当 cluster_resources 选项转为关闭时的回退。
磁盘使用在 VM 内:QEMU 客户代理
Section titled “磁盘使用在 VM 内:QEMU 客户代理”Proxmox 将 VM 的磁盘视为不透明卷:disk 对于 VM 总是 0,仅已知其大小。为了从内部读取使用情况,收集器为每个运行的 VM 询问 QEMU 客户代理(agent/get-fsinfo),其配置启用代理(Options → QEMU Guest Agent)。两个条件:
qemu-guest-agent在 VM 内安装并运行(Debian 和 Ubuntu:apt install qemu-guest-agent;Windows:VirtIO 驱动程序 ISO);- 令牌在 VM 上持有
VM.GuestAgent.Audit— Proxmox VE 9 之前的VM.Monitor(下面的DumbMonit角色在/上授予它)。
根文件系统(/,或 Windows 上的 C:\;失败,最大的一个)给出 guest_disk_used_bytes 和 guest_disk_used_percent,同一系列一个容器有,所以”VM 或容器磁盘几乎满”规则覆盖两个。每个真实文件系统也获得 guest_fs_total/used_bytes 和 guest_fs_used_percent 带 mountpoint 标签;伪文件系统(tmpfs、squashfs、snap mounts)和没有容量的媒体被跳过。
guest_agent_enabled 说 VM 的配置是否启用代理,guest_agent_running 它是否回答。没有代理或正确的权限,VM 保持其大小并简单地没有使用 — 绝不是误导性的”0%”。
客户的操作系统和地址
Section titled “客户的操作系统和地址”Proxmox 只知道在客户配置中写入的操作系统类型(l26、win11),而不是实际运行什么。启用 guest_os 选项时,收集器询问每个运行的客户它是什么:对于 VM 的 agent/get-osinfo 和 agent/network-get-interfaces,对于容器的 /nodes/{node}/lxc/{vmid}/interfaces,在内部不需要任何安装。这给出 guest_os_info(Debian GNU/Linux 12 (bookworm)、其 id、其版本、内核)和最多四个 guest_ip_info — 环回和 IPv6 link-local 地址被跳过,具有数十个虚拟接口的机器不会填满系列数据库。
两个都最多每个客户每小时询问一次,在其间从内存重新发布:操作系统不在两个探针之间变更,地址几乎从不。在五十台运行机器的集群上,这是两个额外调用与每个探针和两个每小时的区别。
这两个代理调用需要 VM.GuestAgent.Audit。Proxmox VE 7 还没有它并使用 VM.Monitor;Proxmox VE 9 移除了 VM.Monitor 并仅保留客户代理权限。没有您的版本知道的那个,这两个系列根本不存在;没有其他东西变化。
Ceph 面板
Section titled “Ceph 面板”当集群实际上有 Ceph 时,Ceph 部分才出现在监控项页面上:健康和它后面的词、总容量和已用容量、有多少 OSD 在上升和在,一个 OSD 表(主机、监控项类别、使用情况、应用和提交延迟)以及一个池表(使用情况、大小和最小大小、放置组对抗自动扩展器会选择的数字)、CephFS 文件系统、设置的 OSD 标志和当前静音的健康检查。
最后两个是仪表板通常隐藏的。noout 为维护设置并从不清除意味着 Ceph 将不会重新平衡死 OSD,一个静音检查不再出现在 HEALTH_OK 中 — 在两种情况下集群看起来健康,同时其冗余悄悄消失。
GET /api/targets/{id}/proxmox/ceph 当集群没有 Ceph 时答复 available: false,这是 UI 知道根本不绘制部分。详情花费单个节点加集群范围的三个调用,无论集群大小,它需要除了 ceph 之外的 ceph_detail 选项。
所有指标都以 dumbmonit_proxmox_ 为前缀。
| 家族 | 指标 | 标签 |
|---|---|---|
| 集群 | cluster_quorate、cluster_nodes、cluster_nodes_online、cluster_member_online;version_info(+ version、release、repoid) | cluster、node |
| 集群库存 | cluster_guests_total、cluster_guests_running、cluster_templates_total(模板分开计数,绝不如”已停止”);pool_guests,每个资源池一个 | pool |
| 节点 | node_up、node_cpu_percent、node_cpu_count、node_load1/5/15、node_memory_used/total_bytes、node_memory_percent、node_swap_used/total_bytes、node_rootfs_used/total/avail_bytes、node_rootfs_percent、node_cpu_iowait_percent(花在磁盘等待上的时间 — CPU 为 10% 且 iowait 为 30% 的节点没有余地)、node_ksm_shared_bytes(页面去重回收的内存)、node_uptime_seconds、node_version_info | node |
| 节点服务 | node_service_running、node_service_state_info(+ state)、node_services_failed、node_core_services_down;node_pve_version_info(+ version、release)对于回答的节点 | node、service |
| 节点网络 | node_interface_active、node_interface_exists、node_interface_autostart、node_interface_mtu、node_interface_offline;总 node_interfaces_offline | node、iface、type(bridge、bond、vlan、eth…) |
| LVM、精简池和挂载 | node_lvm_vg_size/free_bytes、node_lvm_vg_used_percent、node_lvm_vg_physical_volumes(标签 vg);node_thinpool_size_bytes、node_thinpool_used_bytes、node_thinpool_used_percent、node_thinpool_metadata_size_bytes、node_thinpool_metadata_used_percent(标签 vg、pool);node_directory_mount_info(+ path、device、fstype)、node_directory_mounts | node、vg、pool |
| 客户(VM 和容器) | guest_status_info(+ status:running、stopped、paused、suspended、template)、guest_running(对于模板不是)、guest_cpu_percent(分配的内核)、guest_cpu_count、guest_memory_used/total_bytes、guest_memory_host_bytes(Proxmox VE 9:VM 在主机上占用的内存,模拟开销包括)、guest_memory_percent(从客户自己的视角;在 Proxmox VE 9 上它来自气球驱动程序,没有气球的 VM 有字节但没有百分比而不是一个永远高于 100% 的数字)、guest_disk_total_bytes、guest_disk_used_bytes 和 guest_disk_used_percent(容器;VM 仅通过客户代理)、guest_disk_read/write_bytes、guest_network_in/out_bytes(计数器)、guest_uptime_seconds;guest_pool_info(+ pool)、guest_locked(+ lock;系列仅在持有锁时存在,所以它的持续时间直接从图表读取) | node、vmid、name、type(qemu 或 lxc) |
| VM 详情(运行 VM) | guest_agent_enabled、guest_agent_running、guest_balloon_bytes、guest_memory_guest_free_bytes(从内部看到的空闲内存,气球驱动程序)、guest_running_qemu_info(+ version:VM 启动的 QEMU — 在虚拟机管理程序升级后它落后直到 VM 停止并再次启动,活迁移不做);每个文件系统 guest_fs_total_bytes、guest_fs_used_bytes、guest_fs_used_percent | node、vmid、name、type;文件系统:+ mountpoint、fstype |
| 客户系统和地址 | guest_os_info(+ os、os_id、os_version、kernel)、guest_ip_info(+ iface、ip;每个客户最多四个可路由地址)。每小时刷新一次 | node、vmid、name、type |
| 客户网络卡 | guest_netdev_in_bytes、guest_netdev_out_bytes(计数器),每个虚拟接口一对,guest_network_in/out_bytes 仅给出客户的总计 | node、vmid、dev(tap100i0、veth200i0) |
| 存储 | storage_active、storage_enabled、storage_used/total/avail_bytes、storage_used_percent(容量仅在 Proxmox 报告一个时发布:非活存储或 PBS 数据存储其大小 PVE 不读取,获得无而不是零字节) | node、storage、type(dir、lvmthin、zfspool、nfs、pbs…)、shared |
| 备份(每个客户) | backup_present、backup_last_timestamp_seconds、backup_last_age_seconds、backup_last_size_bytes、backup_count;总计 backup_guests_total、backup_guests_without_backup | vmid、name、node、type |
| 备份(vzdump 运行,每个节点) | backup_job_runs、backup_job_failures、backup_job_last_ok、backup_job_last_timestamp_seconds、backup_job_last_age_seconds、backup_job_last_duration_seconds | node |
| 备份作业(计划) | backup_job_enabled、backup_job_next_run_seconds、backup_job_last_ok、backup_job_last_run_age_seconds(仅当 vzdump 任务携带作业 id、PVE 7.2+ 时的最后两个);总计 backup_jobs_total、backup_guests_not_covered;每个客户 backup_covered(0 为没有作业覆盖的客户) | job、storage、schedule;backup_covered:vmid、name、node、type |
| 备份作业覆盖 | backup_job_guests、backup_job_volumes_included、backup_job_volumes_excluded;backup_job_guest_excluded_volumes(+ vmid、name、type、reason),仅为意外排斥发布 | job |
| HA | ha_quorum_ok、ha_fencing_armed(+ state:Proxmox VE 9 报告看门狗是否为 armed 或在 standby 上 — 在待命上没有东西会被隔离)、ha_master_active、ha_lrm_active(node)、ha_resources_total;每个资源 ha_resource_started、ha_resource_error(1 在状态 error、fence 或 recovery 中)、ha_resource_state_info(+ state) | sid、node、vmid、type |
| HA 管理器 | ha_node_online、ha_node_status_info(+ status:online、fence、gone、maintenance)、ha_master_info(持有 CRM 主宰的节点)、ha_manager_age_seconds;每个节点 ha_lrm_mode_info(+ mode、state)、ha_lrm_age_seconds、ha_lrm_stale(1 当 LRM 没有写入两分钟以上时) | node |
| 快照 | guest_snapshot_count、guest_snapshot_oldest_age_seconds、guest_snapshot_newest_age_seconds(仅当计数 > 0 时年龄);guest_snapshot_guests_skipped 当 max_snapshot_guests 超过时 | vmid、name、node、type |
| 复制 | replication_job_enabled、replication_job_error(错误消息或 fail_count > 0)、replication_job_fail_count、replication_job_last_sync_age_seconds、replication_job_next_sync_seconds、replication_job_duration_seconds;replication_jobs_total | job、vmid、node(源)、to_node |
| Ceph | ceph_health(0 OK、1 WARN、2 ERR、3 unknown)、ceph_health_info(+ status)、ceph_osds_total/up/in、ceph_bytes_total/used、ceph_used_percent、ceph_pgs_total、ceph_mons_total | |
| Ceph OSD | ceph_osd_up、ceph_osd_in、ceph_osd_used_percent、ceph_osd_used_bytes、ceph_osd_total_bytes、ceph_osd_apply_latency_ms、ceph_osd_commit_latency_ms、ceph_osd_reweight、ceph_osd_crush_weight;总计 ceph_osds_down、ceph_osds_out | osd、ceph_host、device_class |
| Ceph 池和 CephFS | ceph_pool_used_percent、ceph_pool_used_bytes、ceph_pool_size、ceph_pool_min_size、ceph_pool_pg_num、ceph_pool_pg_num_optimal(自动扩展器会选择什么)、ceph_pool_info(+ type、crush_rule、autoscale)、ceph_pools_total;ceph_fs_info(+ metadata_pool、data_pool)、ceph_fs_total | pool;CephFS:name |
| Ceph 标志和静音 | ceph_flag(1 当标志设置时)、ceph_flags_set;ceph_health_mute_info(+ sticky)、ceph_health_mutes | flag;静音:code |
| 物理磁盘 | node_disk_size_bytes、node_disk_smart_failed(1 当 SMART 健康是 FAILED;当磁盘报告 UNKNOWN 时缺失)、node_disk_health_info(+ health、used:LVM、ZFS、partitions…)、node_disk_wearout_percent(SSD 和 NVMe:0 新,100 额定寿命结束)、node_disk_temperature_celsius(来自 disks/smart:ATA 属性 194/190,或文本报告的温度线 — NVMe 的 Temperature:,SAS 的 Current Drive Temperature:) | node、disk(/dev/sda、/dev/nvme0n1)、model、type(ssd、hdd、nvme) |
| ZFS 池 | node_zfs_pool_degraded(1 除非 ONLINE)、node_zfs_pool_health_info(+ health)、node_zfs_pool_size/alloc/free_bytes、node_zfs_pool_used_percent、node_zfs_pool_fragmentation_percent | node、pool |
| 更新 | node_updates_pending、node_updates_security_pending(其来源、存储库标签、套件、部分或更改日志 URL 命名安全档案的包,例如 Debian 的 bookworm-security)。没有 Sys.Modify 这两个不存在;node_pve_packages_upgradable 然后仍然计数候选版本与已安装版本不同的 Proxmox 包,node_reboot_required(+ running、installed)说安装了更新的内核但未启动 — 两个从 apt/versions 读取,仅需要 Sys.Audit | node |
| 包变更 | node_packages_changed:0 通常;在一个探针看到 Proxmox 包的已安装版本变更后一小时,包变更的数量,具有 changes 标签如 pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node、changes |
| 订阅和存储库 | node_subscription_active、node_subscription_info(+ status:active、notfound、expired…、level、next_due);node_repository_errors(不可读源文件)、node_repository_warnings(Proxmox 自己的警告:企业存储库无订阅、测试存储库)、node_repository_enabled(+ repo:enterprise、no-subscription、test、ceph-*) | node |
| 证书 | node_certificate_expiry_days(过期后为负) | node、filename、subject |
| RRD 流(默认关闭) | node_rrd_<metric>、guest_rrd_<metric>、storage_rrd_<metric> — Proxmox 自己的指标服务器接收的每个测量,在其自己的名称下(见下面的 metrics_export) | node;客户:vmid、type;存储:node、storage |
| 收集 | up、scrape_errors、scrape_duration_seconds |
每台机器的备份年龄回答了家庭实验室最昂贵的失败:备份数周未运行,在恢复日发现。它从 vzdump 任务日志计算(在 backup_lookback_days 上)并且如果 scan_backup_storage 打开,从备份存储上找到的档案。
计划作业来自 Datacenter → Backup:backup_covered 对于 Proxmox 自己列出为不被任何作业覆盖的每个客户是 0,所以昨天创建的机器在第一次被遗漏的备份之前显示而不是在之后。
覆盖一个客户的作业不一定写它的所有磁盘。标记为 backup=0 的卷每晚被跳过,作业仍然报告成功,没有人找出,直到恢复。backup_job_guest_excluded_volumes 命名作业、客户和 Proxmox 自己的排斥原因 — 但仅当排斥是惊人的:CD-ROM 驱动器、cloudinit 镜像或不是卷的条目设计上被排斥,计算在 backup_job_volumes_excluded 并从不按客户报告。没有那个区别,每个具有虚拟驱动器的机器都会引发警报。
节点的守护进程值得观察的一个原因:pvestatd 停止不会破坏任何明显可见的东西 — Web 界面继续显示它死亡时的数字,一切看起来正常。node_core_services_down 仅计数 pve-cluster、pvedaemon、pveproxy、pvestatd、pve-firewall、corosync 和 watchdog-mux,并仅那些节点本身声明为启用的,所以没有 corosync 或 HA 的独立节点计数零缺失。
当设置为在启动时启动且未启动时(或根本不再存在),接口计为离线。一个需求启动的,无自启动,从不报告:它的缺失是正常的。在重启后失败回来的网桥切断附加到它的每个客户,同时这些客户完全运行,没有其他东西说。
填满的 LVM 精简池一次将存储在其上的每个客户置于只读,在客户内删除文件不会取回空间。其元数据活在自己的,远较小的卷上并经常首先饱和,完全同一后果 — 这是为什么两个填充水平是分离系列和分离规则。
包变更由收集器本身检测:它记住来自前一个探针的已安装版本(每个监控项和节点,在内存中 — 服务器重启学习而不报告)。仅一个在两个探针中出现具有不同版本的包计数;新安装或移除的包不。
部分失败(一个节点下降,一个存储慢)仍然是成功的探针:能读的被写入,失败被计入 scrape_errors。根本缺失的功能保持沉默:无 Ceph、无复制作业、无 ZFS 池、无客户代理或无权列出更新产生无系列和无错误。同样的对所有以上:缺失特权(403)、端点一个较旧 Proxmox 没有(404 或 501)、一个未安装的功能(Ceph 答复 500)产生无错误和无指标至所有 — 绝不是零假装是测量。
板温度不可用:Proxmox VE API 不暴露传感器,仅磁盘自己的 SMART 温度。如果您需要更多,在节点上安装 DumbMonit 代理。
应用的内置规则:监控项无法访问、高 CPU、磁盘几乎满、文件系统几乎满(预测)、备份过老、异常 CPU、VM 或容器停止、VM 或容器 CPU 高、VM 或容器内存高、VM 或容器磁盘几乎满、HA 资源错误、集群失去仲裁、节点离线、存储几乎满、备份作业失败、旧快照、复制失败、Ceph 健康错误、Ceph 健康警告、更新待处理、安全更新待处理、Proxmox 包变更、Proxmox 磁盘磨损、Proxmox 磁盘 SMART 失败、Proxmox ZFS 池降级、节点证书过期、精简池几乎满、精简池元数据几乎满、Proxmox 服务下降、节点网络接口下降、Ceph OSD 下降、Ceph OSD 接近满、Ceph 池几乎满、Ceph noout 标志留下、HA 管理器未报告、备份作业排斥磁盘、客户锁定。
完整 RRD 流
Section titled “完整 RRD 流”/cluster/metrics/export 是 Proxmox 自己的指标服务器(InfluxDB、Graphite)消费的端点:pvestatd 测量的一切,对于整个集群,在一个调用中。两件事使它值得有。
- 它携带测量没有其他地方暴露的 — 特别是每节点压力停滞信息(PSI):任务花在等待 CPU、磁盘或内存上多长时间。那是当 CPU 和内存两个看起来都很好时解释”一切都很慢”的数字。
- 它从已看到的最后一点以
history=1读取,所以两个探针之间的每个点在它自己的时间戳上被摄入。每五分钟探测的监控项获得其五个一分钟点而不是单个当前值。
它默认关闭,那是故意的权衡。这些系列部分重复其他集合已产生的,在更好的名称下,所以打开 metrics_export 添加大量系列存储和筛选的细节大多数安装永不看的。名称发布正是 Proxmox 发送的(node_rrd_pressure_cpu_some_avg10、guest_rrd_netin…)而不翻译:Proxmox 在每个发布添加新的,一个写在这里的翻译表会在下个被错误。它需要 Sys.Audit 在 / 上 — 当 DumbMonit 角色在 / 上授予时已经有了。
在 Proxmox 中准备什么
Section titled “在 Proxmox 中准备什么”下面的步骤是表单旁的通知显示的步骤。原则:为监视保留的用户,一个仅能读取的角色,一个令牌 — 从不是您登录的账户。
-
在任何节点上打开 shell(在 Web UI 中:选择节点,然后 Shell;或 SSH)并创建为监视保留的用户。它不需要密码:令牌是登录的东西。
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
创建仅具有收集器使用的权限的角色:Sys.Audit(节点、集群、HA、磁盘和 SMART、ZFS、证书、包版本、订阅)、Datastore.Audit(存储和备份档案)、VM.Audit(VM、容器、快照)和 VM.GuestAgent.Audit(QEMU 客户代理在 VM 内读取的内容:磁盘使用、操作系统、IP 地址)。它们都不能改变任何东西。
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
给用户整个集群的那个角色。
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
创建用户的 API 令牌。权限分离关闭,所以令牌简单地继承用户的权限。
pveum user token add dumbmonit@pve monitor --privsep 0 -
命令打印具有完全令牌 ID 和值的表。复制完全令牌 ID 到 DumbMonit 的 Token ID 字段和值(UUID)到其 Secret 字段。秘密显示一次:如果丢失,移除令牌并创建新的。
dumbmonit@pve!monitor -
可选,计算待处理更新和待处理安全修复:Proxmox 用 Sys.Modify 保护该列表。仅在 /nodes 上授予它;没有它收集器默认跳过列表。
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
在较旧的 Proxmox 上,VM.GuestAgent.Audit 可能尚不存在,命令被拒绝为无效权限:客户代理调用则被 VM.Monitor 覆盖,Proxmox VE 9 反过来移除。使用无论您的版本知道哪个。
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
更喜欢 Web UI?同样的步骤活在 Datacenter → Permissions 下:Users、Roles、Add → User Permission,然后 API Tokens 带”Privilege Separation”未勾选。
-
在 DumbMonit 中,输入任何节点的地址(默认端口 8006)。
供应商文档:Proxmox VE 用户管理。
| 凭据 | 字段 |
|---|---|
| API 令牌(推荐) | Token ID:用户、域和令牌名如 Proxmox 显示的,dumbmonit@pve!monitor。Secret:创建令牌时显示的 UUID。无过期、无在虚拟机管理程序上打开的会话。 |
| 用户名 / 密码 | user@realm 和密码。获得一张票证,缓存并在其两小时过期前十分钟更新。 |
API 接受两片中的令牌(token_id + secret)或如较旧版本做的那样,作为一个字符串 token = user@realm!name=secret;两个以相同方式存储。一个整个令牌粘贴到 Token ID 被形式分割。
上面的 DumbMonit 角色携带 PVEAuditor 授予收集器读取的路径加客户代理权限:收集器仅做 GET。每个端点:Sys.Audit 对于 /version、/cluster/*、/nodes/{node}/status、services、version、network、netstat、tasks、replication、certificates/info、disks/list、disks/smart、disks/zfs、apt/versions、apt/repositories 和 subscription;Datastore.Audit 对于 storage 和 storage/{id}/content;VM.Audit 对于 qemu、lxc、snapshot、status/current 和容器的 interfaces;VM.GuestAgent.Audit — 或 Proxmox VE 9 前的 VM.Monitor — 对于 agent/get-fsinfo。
两个路径要求比其他多一点,两个都被作为授予的角色覆盖在步骤 3 中 — 在 /,而不是在 /nodes:
Sys.Audit在/对于 LVM 库存(disks/lvm、disks/lvmthin、disks/directory)和/cluster/metrics/export,可选的 RRD 流。仅在/nodes上授予,精简池系列和*_rrd_*系列无声地缺失。VM.GuestAgent.Audit对于两个客户代理调用读取 VM 的操作系统和地址(agent/get-osinfo、agent/network-get-interfaces)。Proxmox VE 7 没有那个权限并使用VM.Monitor;Proxmox VE 9 放弃了VM.Monitor。没有您的版本知道的那个,guest_os_info和guest_ip_info根本不为 VM 发布;容器,不需要代理,保留它们的地址。
角色根本不覆盖的唯一的东西是待处理更新列表(apt/update),Proxmox 用 /nodes 上的 Sys.Modify 保护 — 可选,如步骤 6 解释;没有它收集器跳过 node_updates_pending 和 node_updates_security_pending 无声地。
(在 aclmod 命令中为一个以”Privilege Separation”勾选创建的令牌使用 -token 'dumbmonit@pve!monitor' 而不是 -user。)
地址:10.0.0.10、pve.lan、pve.lan:8006、[fd00::1] 或完整 URL https://pve.example.net。https 方案和端口 8006 在缺失时添加。
| 键 | 标签 | 默认值 | 帮助 |
|---|---|---|---|
port | API 端口 | 8006 | 当地址没有给出端口时使用。 |
insecure_tls | 接受不可验证的证书 | false | Proxmox 默认带有自签名证书:如果因此拒绝连接,启用此选项。 |
request_timeout_seconds | 每个请求的超时(秒) | 10 | 为每个 API 调用分配的时间,从 1 到 120。 |
backup_lookback_days | 备份回溯(天) | 31 | 较旧备份任务不被检查,从 1 到 3650。 |
scan_backup_storage | 库存备份档案 | true | 扫描备份存储给每台机器的最后备份日期。如果存储响应缓慢,禁用。 |
nodes | 监视的节点 | (空) | 要监视的节点名,用逗号分隔。空:集群中的每个节点。 |
cluster_resources | 读取集群库存 | true | 一个调用到 /cluster/resources 列出每个节点、客户、存储和池。保持打开:这是仍能看到停止响应的节点的客户的唯一来源,它节省每个节点两个调用。关闭,收集器走 /nodes/{node}/qemu 和 /nodes/{node}/lxc 改为,并失去池和锁。 |
services | 观察节点服务 | true | /nodes/{node}/services 和 version:每个节点的 Proxmox 守护进程的状态和安装在其上的版本。停止的 pvestatd 留下整个集群显示冻结数字。 |
network | 观察节点网络 | true | /nodes/{node}/network 和 netstat:网桥、债券和 VLAN 及其链路状态,加每个客户网络卡的流量计数器。 |
lvm | 观察 LVM 和精简池 | true | disks/lvm、disks/lvmthin 和 disks/directory:卷组、精简池(数据和元数据填充)和 PVE 管理的目录挂载。需要 / 上的 Sys.Audit;否则无声。 |
ha | 高可用性 | true | 读取 /cluster/ha/status/current 和 manager_status:仲裁、CRM 主宰、管理器自己的每个节点视图、每个 LRM 及其最后报告的年龄以及每个 HA 资源。 |
backup_jobs | 计划备份作业 | true | 从 Datacenter → Backup 读取作业和没有作业覆盖的客户。 |
scan_snapshots | 库存快照 | true | 每个客户一个调用(每个节点四个进行中)。在非常大的集群上禁用。 |
max_snapshot_guests | 快照库存限制 | 200 | 超过这个数字的客户每个探针被跳过并计入 guest_snapshot_guests_skipped,从 1 到 10000。 |
replication | 复制作业 | true | 每个节点的存储复制状态。节点无作业时无声。 |
ceph | Ceph 健康 | true | 读取 /cluster/ceph/status。未安装 Ceph 时无声。 |
ceph_detail | 详细观察 Ceph | true | 每 OSD 状态、使用和延迟、每池使用、CephFS、OSD 标志和静音的健康检查。一个节点加两个集群范围的三个调用,无论集群大小。需要 ceph 打开;无 Ceph 时无声。 |
backup_volumes | 检查备份作业包含什么 | true | 对于每个计划作业,它覆盖的客户和它实际写的它们的磁盘。捕捉每晚成功同时跳过数据磁盘的作业。每个作业一个调用。 |
guest_os | 读取客户操作系统和地址 | true | 从每个运行客户内部看到的操作系统和 IP 地址(VM 的 QEMU 客户代理、容器的命名空间)。每个客户每小时刷新一次,不在每个探针。Proxmox VE 8 需要 VM.GuestAgent.Audit。 |
metrics_export | 摄入完整的 RRD 指标流 | false | 读取 /cluster/metrics/export,Proxmox 自己的指标服务器消费的流,包括每节点压力停滞(PSI),和自最后一个探针的每个点而不仅仅是当前的。默认关闭:*_rrd_* 系列它添加部分重复已收集的。需要 / 上的 Sys.Audit。 |
updates | 待处理更新 | true | 计数包 apt/update 列出。需要 /nodes 上的 Sys.Modify(见上面);否则无声。 |
certificates | 证书过期 | true | 每个节点证书(pve-ssl.pem、pveproxy-ssl.pem、pve-root-ca.pem)中的天数剩余。 |
guest_agent | 询问 QEMU 客户代理 | true | 对于每个运行 VM:status/current(气球、代理标志)和当代理启用时,agent/get-fsinfo(需要 VM.GuestAgent.Audit)。每个节点四个调用进行中。代理缺失时无声。 |
disks | 观察物理磁盘 | true | disks/list 加每个磁盘一个 disks/smart 调用:健康、磨损、温度。 |
zfs | 观察 ZFS 池 | true | disks/zfs:健康、容量、碎片。无 ZFS 时无声。 |
packages | 检测包变更 | true | apt/versions 与前一个探针比较;变更在 node_packages_changed 中报告一小时。 |
subscription | 观察订阅和存储库 | true | subscription 和 apt/repositories:状态、警告、启用的标准存储库。 |
| 症状 | 可能原因 |
|---|---|
| 监控项上显示证书错误 | 自签名证书。要么安装受信任的证书(ACME 内置于 Proxmox),要么启用 insecure_tls。选项绝不会隐式启用。 |
| 认证错误 | Secret 粘贴到 Token ID(或相反),“Privilege Separation”留下勾选(令牌则没有权限),或 DumbMonit 角色未在 / 上应用。 |
| 客户缺少备份年龄 | 回溯窗口中无 vzdump 任务和存储上没找到档案;或 scan_backup_storage 禁用。 |
| 慢探针 | 花长时间列出的备份存储或许多客户库存快照。禁用 scan_backup_storage 或 scan_snapshots、降低 max_snapshot_guests 或升高 request_timeout_seconds。 |
node_updates_pending 缺失 | 用户或令牌缺少 /nodes 上的 Sys.Modify。授予步骤 6 的 DumbMonitUpdates 角色,或忽略:node_pve_packages_upgradable 和 node_reboot_required 无它覆盖 Proxmox 包。 |
| VM 无内存百分比 | Proxmox VE 9 报告,在集群库存中,VM 在主机上占用的内存 — 开销包括,所以永远规律地高于 100%。从它计算的百分比会永远坐在 100% 以上。诚实的数字来自客户内的气球驱动程序;禁用了气球的 VM 因此显示字节和无百分比。guest_memory_host_bytes 是主机侧数字。 |
| 备份存储无容量 | Proxmox 备份服务器数据存储挂载于 PVE 报告无大小:PVE 不读它。数据存储自己的监控项页有它。 |
| VM 磁盘使用为空(“仅大小”) | VM 无 QEMU 客户代理(在其选项中未启用或 qemu-guest-agent 未在内部安装),或令牌缺少 VM.GuestAgent.Audit。guest_agent_enabled 和 guest_agent_running 告诉哪个。容器从不需要它。 |
无 node_disk_* 系列 | 令牌缺少 / 上的 Sys.Audit(DumbMonit 角色授予),或节点在 RAID 控制器后面运行隐藏 SMART:disks/list 然后报告 UNKNOWN 和无 node_disk_smart_failed 发布。 |
node_packages_changed 在服务器重启后触发 | 不:重启后第一个探针仅学版本。变更仅在同一服务器进程的两个连续探针之间报告。 |
backup_job_last_ok{job=…} 缺失同时 backup_job_last_ok{node=…} 存在 | vzdump 任务不携带作业 id(Proxmox VE 比 7.2 旧或作业手工运行)。每节点运行状态仍然存在。 |
| 无 Ceph 或复制指标 | 没什么报告:Ceph 未安装或无复制作业配置。不是错误。 |
| 节点卡上无精简池或卷组 | lvm 选项关闭、节点无 LVM 或用户仅在 /nodes 上持有 Sys.Audit — 那个库存要求它在 /。 |
| 集群有 Ceph 时 Ceph 部分缺失 | ceph 或 ceph_detail 关闭,或每个节点答复详情调用时出错。available: false 在 /api/targets/{id}/proxmox/ceph 上意味着”无 Ceph 这里”,不是”尚未收集”。 |
| VM 无操作系统或 IP 地址 | QEMU 客户代理未启用或未在那个 VM 中安装,或令牌缺少 Proxmox VE 8 上的 VM.GuestAgent.Audit(步骤 7)。容器不需要代理。刚启动的客户等待最多一小时:事实每小时刷新一次,不在每个探针。 |
| 客户保持锁定徽章 | 中断的备份、迁移或快照留下它。对于 VM 的 qm unlock <vmid>、对于容器的 pct unlock <vmid> — 在检查作业确实结束后。 |
pve_backup_excludes_disk 在具有 CD-ROM 的机器上触发 | 不:驱动、cloudinit 镜像和不是卷的条目设计上被排斥,从不按客户报告。触发的是一个携带 backup=0 的真实磁盘。 |
无 *_rrd_* 系列 | metrics_export 关闭(默认),或用户缺少 / 上的 Sys.Audit。 |