
Como funciona o sistema de alertas
Este conteúdo não está disponível em sua língua ainda.
Regras úteis estão ativas logo após a instalação; nada precisa de ajuste. O que faz a diferença no uso diário é o que mantém o ruído baixo: supressão por dependência, agrupamento por host, janelas de manutenção, e uma linha de base que aprende antes de falar.
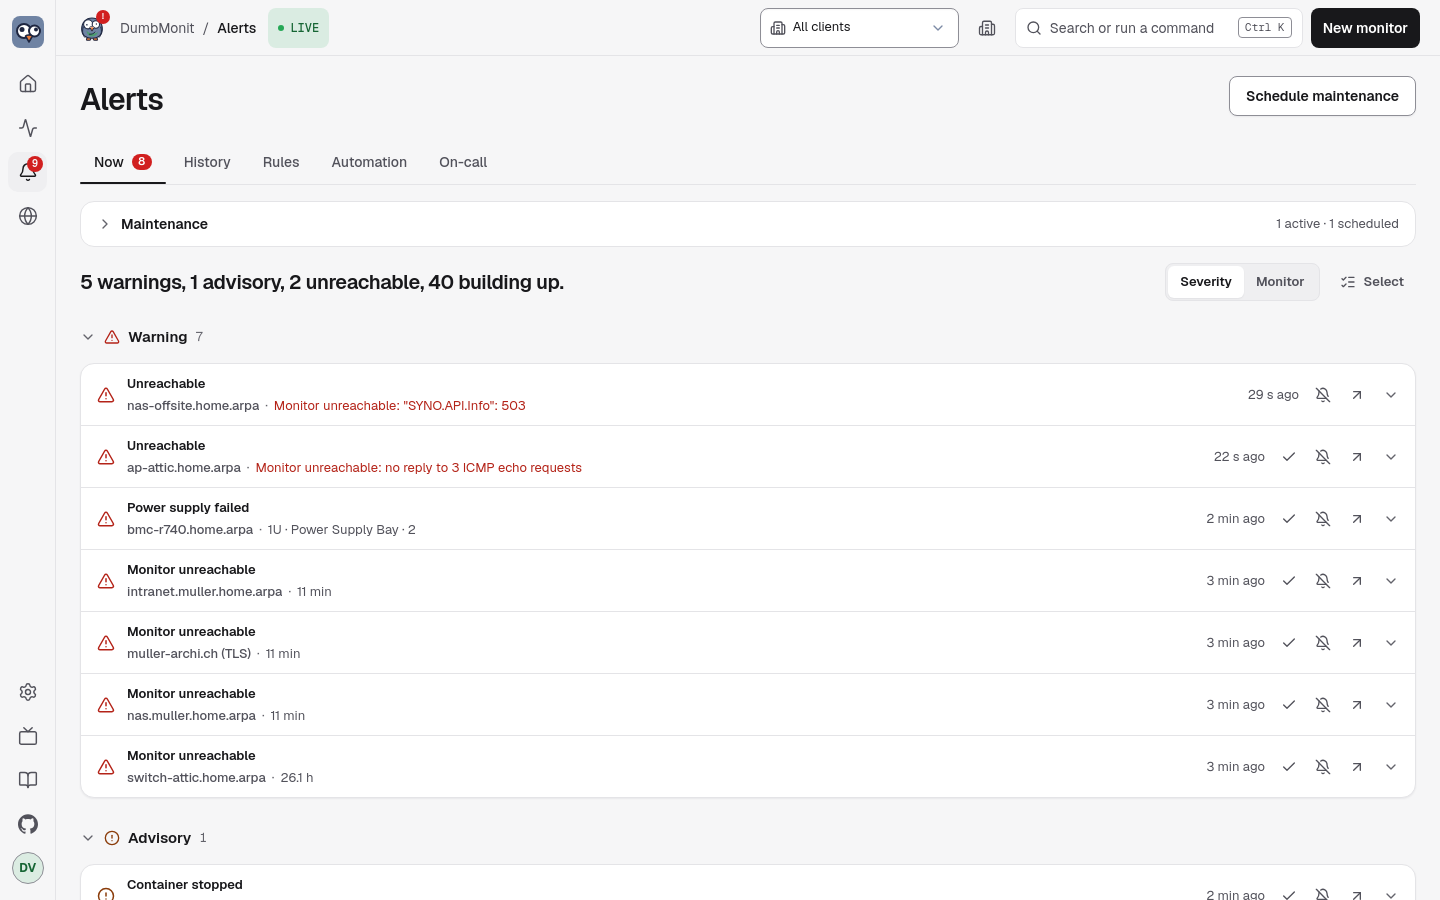
Severidades
Seção intitulada “Severidades”A interface fala a escada do boletim meteorológico. A API e o editor de regras armazenam os mesmos três níveis sob seus nomes de motor.
| Na interface | Na API (severity) | Significado |
|---|---|---|
| Info | info | Vale a pena saber, nenhuma ação esperada. Usado pela regra de linha de base. |
| Aviso | warning | Precisa de atenção em breve: CPU alta, disco quase cheio, serviço lento. |
| Alerta | critical | Precisa de você agora: monitor inacessível, serviço fora do ar, verificação de backup falhou, certificado expirado. |
O escalonamento eleva a severidade de uma regra um nível depois de
escalate_after se o alerta continuar disparando (Info → Aviso → Alerta;
Alerta permanece).
Todo alerta é uma máquina de estados, avaliada a cada 30 segundos
(DUMBMONIT_ALERT_INTERVAL_SECS).
| Fase | Na interface | Significado |
|---|---|---|
ok | — | A condição é falsa. |
pending | Acumulando | A condição é verdadeira mas a retenção da regra (for) ainda não decorreu. Nada é enviado. |
firing | Disparando | A condição se manteve por tempo suficiente. A primeira notificação sai, depois lembretes a cada repeat_interval (6 horas por padrão para a maioria das regras integradas), depois um escalonamento se configurado. |
resolved | Resolvido | De volta ao normal. Uma notificação de resolução é enviada apenas se o disparo havia sido anunciado. |
suppressed | Suprimido pelo pai | O alerta está disparando, mas um monitor pai está fora do ar, ou o próprio monitor está inacessível: veja abaixo. |
phase é o estado do motor; effective_phase é o que você lê. Um alerta
cujo effective_phase é suppressed mantém phase = firing por baixo,
então não é notificado de novo quando o pai se recupera.
Um alerta também pode ser reconhecido (acked, com acked_by,
acked_until e ack_note): a fase não muda, lembretes e escalonamentos
pausam até acked_until, a resolução ainda é notificada e limpa o
reconhecimento. Colocar em soneca um alerta funciona da mesma forma por
baixo, mas através de uma janela de manutenção restrita aos rótulos exatos
daquele alerta (silenced: true), em vez do monitor inteiro: uma
regra irmã no mesmo monitor continua falando. Veja
Se livrando de um alerta.
Supressão por dependência
Seção intitulada “Supressão por dependência”Qualquer monitor pode declarar um monitor pai. Quando um monitor está fora
do ar, todo alerta em seus descendentes é marcado Suprimido pelo pai em vez
de ser enviado: um switch que cai produz uma notificação, não trinta. O
ancestral fora do ar mais próximo é nomeado como a causa (suppressed_by), e a
cadeia é seguida até 64 níveis.
Um monitor está fora do ar quando um destes alertas dispara nele, seja qual for a causa:
- Monitor unreachable: nenhuma medição (um dispositivo SNMP que parou de responder, um agente que parou de enviar);
- Service down: sua verificação de disponibilidade roda, mas falha (um ping com 100 % de perda, uma verificação HTTP que dá erro ou estoura o tempo, uma porta TCP fechada, e assim por diante).
Um simples aviso no pai (disco cheio, CPU alta, serviço lento, certificado prestes a expirar) não esconde nada: o dispositivo continua respondendo, e o que está por trás também. O pai mantém seu próprio alerta e sua notificação; quando ele se recupera, os filhos que continuam fora do ar disparam e são notificados por conta própria.
O mesmo vale para o próprio monitor inacessível: seus outros alertas
(disco cheio, CPU etc.) são suprimidos pela sua própria queda, com
suppressed_by apontando o próprio monitor, já que seus valores estão
desatualizados e são apenas um sintoma da mesma falha. Só o alerta “Device
unreachable” dele nunca é ocultado pela própria queda, então você é avisado
uma vez.
Defina o pai no formulário do monitor. Na página Monitores, os filhos se agrupam sob seu pai e escurecem quando ele está fora do ar.
Um agente relay conta como pai de todo monitor que sonda (Alcançado através de no formulário do monitor), além do pai definido explicitamente: quando o relay está fora do ar, seus monitores são suprimidos com o relay nomeado como a causa. A distâncias iguais, o pai explícito vence.
Um pai também conta como fora do ar assim que sua própria sondagem o diz (o status Tempo esgotado, Monitor unreachable ou Service down em sua página), sem esperar que seu alerta dispare: um agente que para de enviar leva seus monitores com ele um ou dois minutos antes de seu próprio alerta, e um switch cujo ping acabou de falhar esconde seus filhos antes de a espera de “Service down” terminar; de outra forma, cada um notificaria primeiro.
Agrupamento, deduplicação, lembretes
Seção intitulada “Agrupamento, deduplicação, lembretes”Sem agrupamento, um NAS cujo RAID degrada enviaria uma mensagem por disco,
por ciclo. O DumbMonit envia no máximo uma mensagem por host e por ciclo,
mesmo que contenha cinco linhas. Cada alerta é notificado uma vez quando
começa a disparar (firing), depois só como lembrete (reminder, a cada
repeat_interval), um escalonamento (escalation) ou uma resolução
(resolved). O histórico de alertas registra toda transição com se foi
notificada e, se não, por quê (aprendizado, suprimido, silenciado,
reconhecido).
Janelas de manutenção
Seção intitulada “Janelas de manutenção”Um silêncio interrompe notificações sem parar a avaliação: no fim de uma janela, um alerta que ainda está ativo é notificado uma vez, em vez de “nascer” depois de duas horas de existência. Janelas são pontuais ou semanais, por monitor ou para toda a instância. Veja Janelas de manutenção.
Aprendizado de linha de base
Seção intitulada “Aprendizado de linha de base”A regra “CPU inusual” não precisa de limite. Para cada série ela mantém
168 baldes, um por (dia da semana, hora), e compara cada ponto com o que é
normalmente observado naquele momento. O score é robusto (mediana e MAD,
uma EWMA por balde com alpha = 0.05), então um único incidente não
reescreve a linha de base, e desvios sazonais são seguidos.
A regra permanece silenciosa por seus primeiros quatorze dias de aprendizado: cada balde precisa ter sido visto pelo menos duas vezes para distinguir “inusual” de “nunca observado”. Nesse meio tempo é mostrada com uma marca de aprendendo e só diz o que teria disparado. Linhas de base de séries que desapareceram são esquecidas depois de 60 dias.
Previsões
Seção intitulada “Previsões”Dois tipos de alerta preveem em vez de reportar, e a visão geral os lista
sob Previsões: a anomalia de linha de base, e as regras predict que
extrapolam uma série com predict_linear() do lado do VictoriaMetrics
(“Filesystem almost full” dentro de quatro dias). A estimativa de
datastore do PBS é um limite simples sobre a própria previsão do PBS.
Para onde vão as notificações
Seção intitulada “Para onde vão as notificações”Regras integradas não têm canal associado, o que significa todo canal ativado. Uma regra que você edita pode nomear canais específicos. Canais são configurados em Configurações → Notificações e relatórios; veja Canais de notificação.
Notificações inteligentes
Seção intitulada “Notificações inteligentes”Tudo acima decide se um alerta pode falar. Um segundo estágio, a política de notificação, decide quando e em qual canal, para que ninguém seja inundado de mensagens. O caminho completo de um alerta, em ordem:
- Avaliar — limite, score de anomalia ou previsão, com a retenção da
regra (
for) e, quando definido, seu limite de limpeza (histerese: dispara acima de 90%, limpa só abaixo de 85%) e qualquer substituição por monitor. - Deduplicar — uma impressão digital por (regra, série), com chave no
id do monitor (
target) em vez de seu nome: renomear um monitor ou editar suas tags não cria um segundo alerta, e uma série que resolve para a mesma chave duas vezes produz um alerta. Séries de um monitor excluído ou pausado são descartadas: seus alertas se limpam imediatamente, sem notificação, e o histórico registradevice removed or disabled. - Suprimir por dependência — descendentes de um monitor fora do ar permanecem quietos.
- Silenciar — janelas de manutenção silenciam o que cobrem.
- Agrupar por monitor — uma mensagem por monitor por ciclo, lembretes e escalonamento incluídos.
- Retenção de oscilação — uma impressão digital que dispara e limpa 4 vezes em 30 minutos envia um único aviso de “oscilando”, depois nada por 30 minutos.
- Filtros por canal — severidade mínima, “me diga quando limpar” ativado/desativado, e um intervalo mínimo entre duas mensagens sobre o mesmo alerta.
- Horas de silêncio (por canal) — só alertas de nível Alerta passam; o resto espera por um resumo quando as horas de silêncio terminam (um alerta que limpa nesse meio tempo é apenas mencionado como “resolvido durante horas de silêncio”).
- Lotes — alertas dentro da janela de lote (60 s por padrão) saem como uma mensagem por canal: “3 alertas em 2 monitores, 1 resolvido”.
- Limite por hora — passado
max_per_hourmensagens em um canal, alertas esperam e chegam como um resumo (“…e mais 7 alertas”). - Enviar — com um link “Abrir no DumbMonit” por monitor quando uma URL pública é conhecida.
Os passos 6 a 10 são configurados em Configurações → Notificações e relatórios → Política de notificação (global) e em cada canal (Opções de entrega). Veja Política de notificação.