
Proxmox Backup Server
Servidor de copias de seguridad: un calendario de copias de treinta días por máquina, tareas fallidas con sus registros, trabajos programados (sync, verify, prune, recolección de basura), datastores, discos y pools ZFS, actualizaciones pendientes, los servicios y versiones de paquete del propio servidor, y el nivel de cinta cuando lo hay.
La página del monitor
Sección titulada «La página del monitor»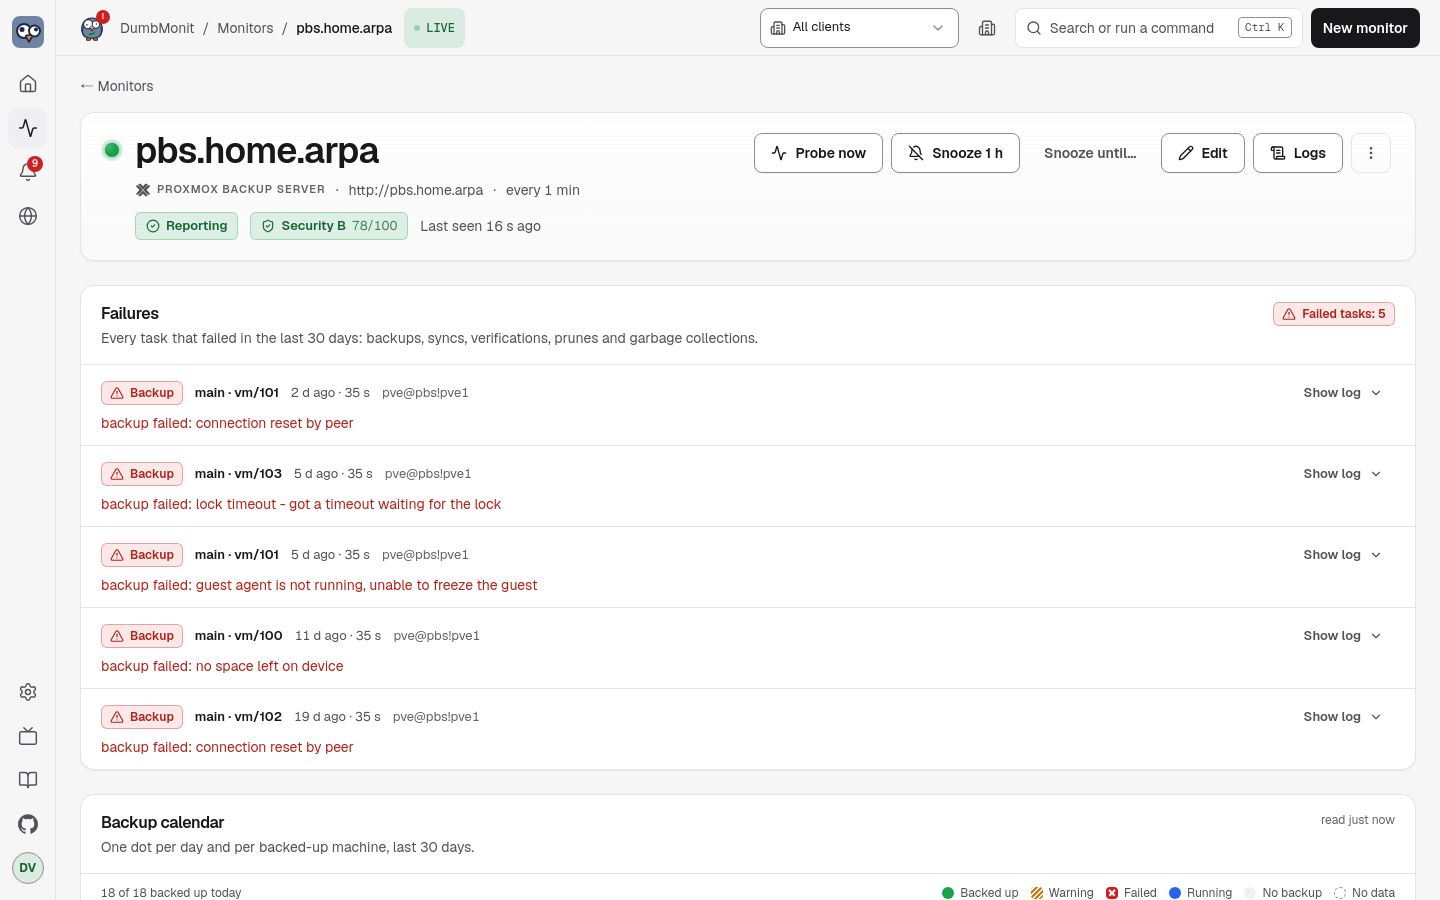
Más allá de las gráficas genéricas, un monitor PBS muestra seis paneles, leídos de lo que guardó la sonda — abrir la página nunca consulta al propio PBS:
- Failures — cada tarea que falló en los últimos 30 días (backup,
sync, verify, prune, GC), la más reciente primero, con su tipo, qué
afectó, cuándo empezó y el propio mensaje de error de PBS. Show log
obtiene las últimas líneas del registro de tarea desde PBS a petición
(
/nodes/localhost/tasks/{upid}/log). - Backup calendar — una fila por máquina respaldada (datastore,
namespace,
type/id, y el nombre del invitado cuando PVE lo escribió en las notas del snapshot), un punto por día: verde azulado cuando una copia tuvo éxito ese día (una tarea terminóOK, o existe un snapshot — los grupos sincronizados no tienen tarea local), rojo cuando una tarea de copia falló y ninguna tuvo éxito, ámbar cuando la copia está ahí pero su verificación falló, azul mientras una se ejecuta, gris cuando no pasó nada. El tooltip de cada punto da la hora, tamaño, duración y extracto de error; la fila dice cuándo fueron el último éxito y el último fallo, el recuento de snapshots, el tamaño del snapshot más reciente y la retención del job de prune que se aplica. Una máquina cuyas copias fallan todas no tiene ningún snapshot y aun así aparece — a partir de sus tareas. - Jobs — cada job de sync, verify y prune y el GC de cada datastore, con programación, última ejecución, resultado, próxima ejecución; una última ejecución fallida recibe una placa roja y el texto de error, los fallos se ordenan primero.
- Tape — solo cuando el servidor tiene un nivel de cinta. Jobs de copia a cinta con su pool, unidad, la etiqueta de la próxima cinta esperada, la última ejecución y su error; pools de medios con sus políticas de asignación y retención, cuántas cintas contienen, cuántas han caducado y si están cifradas; unidades y cambiadores; y las propias cintas con su estado, conjunto de medios, ubicación y bytes escritos.
- Datastores and disks — barra de uso, el propio pronóstico de
llenado de PBS, factor de deduplicación, último GC; pools ZFS con su
salud; discos físicos con el veredicto SMART y el desgaste de SSD, y
la tabla SMART completa a petición
(
/nodes/localhost/disks/smart). Por datastore también muestra una placa de mantenimiento o «Not mounted», una placa «Busy: n writes, n reads», el crecimiento medido por día y sobre cuántos días de historial, cuántas máquinas de cada tipo contiene, cuánto tardó el último GC, y una línea de aviso cuando ese GC encontró chunks ilegibles. - Server — las unidades systemd, con las que el servidor no puede evitar señaladas; las versiones de paquete de Proxmox (instalada, disponible, en ejecución), con una placa «Restart pending» cuando el demonio va por detrás de su paquete; el certificado y su caducidad; y las reglas de control de tráfico con sus límites y qué transportan.
El calendario divide los días en la medianoche local del navegador. Su
historial viene de la lista de tareas: la primera sonda tras un inicio
lee los últimos 30 días
(/nodes/localhost/tasks?since=…&limit=5000), las sondas posteriores
solo la ventana de tareas, y el servidor guarda la unión en SQLite
(pbs_task_history, 35 días, como máximo 10000 tareas por monitor)
así que el calendario sobrevive a los reinicios.
Qué vigila
Sección titulada «Qué vigila»Todas las métricas tienen el prefijo dumbmonit_pbs_.
| Familia | Métricas | Etiquetas |
|---|---|---|
| Nodo | node_cpu_percent, node_cpu_count, node_iowait_percent (tiempo de CPU esperando E/S — en un servidor de copias esto es lo que indica que los discos están saturados), node_load1/5/15, node_memory_used/total/free_bytes, node_memory_used_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_uptime_seconds, node_kernel_info, version_info | |
| Datastores | datastore_available, datastore_bytes_used/total/avail, datastore_used_percent, datastore_estimated_full_seconds (la propia estimación de PBS; ausente mientras le falten datos o el uso esté disminuyendo), datastore_dedup_factor, datastore_removable_unmounted (1 cuando un datastore extraíble está notmounted — no es un error, simplemente no está conectado; etiqueta mount_status), datastore_backend_info (etiqueta backend, filesystem o s3), datastore_maintenance (1 cuando el datastore se retiene por mantenimiento; etiqueta mode, offline, read-only…), datastore_groups y datastore_snapshots (etiqueta type, vm/ct/host/other), datastore_active_reads, datastore_active_writes (qué retiene el datastore ahora mismo — esto explica una recolección de basura que no terminará), datastore_growth_percent_per_day, datastore_growth_bytes_per_day, datastore_history_days | datastore |
| Recolección de basura | gc_last_removed_bytes, gc_last_pending_bytes, gc_last_run_ok (PBS 3.3+), gc_last_success_age_seconds, gc_last_duration_seconds, gc_disk_chunks, gc_last_pending_chunks, gc_last_removed_chunks, gc_bad_chunks (chunks que el GC encontró ilegibles y dejó en su sitio — corrupción, no espacio a recuperar: una copia que los referencia ya no se puede restaurar), verify_last_success_age_seconds, sync_last_success_age_seconds | datastore |
| Grupos de copia | backup_count, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_last_verified (1 verificado, 0 fallido, ausente si nunca se verificó) | datastore, namespace, backup_type, group |
| Namespaces | namespace_groups, namespace_snapshots (el namespace raíz es namespace="") | datastore, namespace |
| Tareas en la ventana | tasks_running, tasks_ok, tasks_failed | worktype (backup, verificationjob, garbage_collection, prune, syncjob…) |
| Jobs | job_enabled, job_last_ok (1 para OK o WARNINGS: n, 0 en caso contrario, ausente si el job nunca se ejecutó), job_never_run (1 cuando un job está activado, tiene una programación y nunca se ha ejecutado — no tiene ni fallo ni éxito, así que es invisible en todas partes), job_last_run_age_seconds, job_next_run_seconds (negativo cuando está vencido), sync_jobs_total, verify_jobs_total, prune_jobs_total; alias sync_job_last_ok para la regla | job, datastore, kind (sync, verify, prune); remote (remote:remote-store, o local) en los jobs de sync — el alias lleva job, datastore, remote |
Cinta (opción tape, desactivada por defecto, cinco llamadas) | tape_backup_job_last_ok, tape_backup_job_never_run, tape_backup_job_last_run_age_seconds, tape_backup_job_next_run_seconds, tape_backup_jobs_total; tape_drive_info (serie de presencia), tape_drives_total, tape_changers_total, tape_media_pools_total; tape_media_total, tape_media_writable, tape_media_expired, tape_media_bytes_used | job, datastore, pool, drive en los jobs; drive, vendor, model, changer en tape_drive_info; pool en los recuentos de medios |
| Discos (mismos nombres que Proxmox VE) | node_disk_size_bytes, node_disk_smart_failed (0 passed, 1 failed; ausente cuando SMART no dio veredicto), node_disk_health_info (serie de presencia; etiquetas health, serial, used), node_disk_wearout_percent (resistencia usada, solo SSD, tal como lo muestra PBS: 100 − wearout) | disk (/dev/sda), model, type |
| Pools ZFS (mismos nombres que Proxmox VE) | node_zfs_pool_degraded (0 ONLINE, 1 en caso contrario), node_zfs_pool_health_info (etiqueta health), node_zfs_pool_size_bytes, node_zfs_pool_alloc_bytes, node_zfs_pool_free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | pool |
| Actualizaciones | node_updates_pending (número de paquetes con actualización disponible) | |
Versiones (opción updates, de /nodes/localhost/apt/versions) | node_package_upgradable (1/0), node_package_info (serie de presencia; etiquetas installed, available, running), node_running_version_stale (1 cuando el paquete proxmox-backup-server instalado ya no es el demonio que se ejecuta — el paquete se actualizó, los servicios no se reiniciaron) | package, restringido a proxmox-backup, proxmox-backup-server, proxmox-backup-client, proxmox-kernel-helper |
Servicios (opción services, una llamada) | node_service_active (1 en ejecución, 0 no), node_service_enabled (ausente para una unidad static, que otra unidad arrastra y que por lo tanto no está ni activada ni desactivada), node_services_total | service, expected ("1" para proxmox-backup, proxmox-backup-proxy y proxmox-backup-banner, las unidades sin las que el servidor no puede funcionar; cualquier otra unidad igual obtiene su serie, con expected="0", y nunca genera una alerta) |
Certificado (opción certificates, desactivada por defecto) | node_certificate_expires_seconds, negativo una vez caducado | certificate (el nombre de archivo), issuer |
Control de tráfico (opción traffic_control) | traffic_rate_in_bytes, traffic_rate_out_bytes (medidos en el instante de la sonda), traffic_limit_in_bytes, traffic_limit_out_bytes (el límite configurado, analizado de las cadenas decimales de PBS como 100 MB; ausente cuando esa dirección no tiene límite, en lugar de un cero que se leería como «todo está bloqueado»), traffic_rules_total | rule |
| Límites y recolección | backup_groups_total, backup_groups_dropped, up, scrape_errors, scrape_duration_seconds |
Una tarea que termina en WARNINGS: n cuenta como exitosa. Las
llamadas por datastore se limitan a cuatro en paralelo: listar
snapshots lee los índices del datastore, y una ráfaga ralentizaría la
copia en curso.
Las listas de job no se limitan a la ventana de tareas: un job de sync
que lleva tres semanas fallando sigue reportándose como fallido. Un job
que nunca se ejecutó no tiene serie job_last_ok, pero sí obtiene
job_never_run, y la regla «PBS job never ran» se activa exactamente
en ese caso.
La recolección de basura se lee con una única llamada /admin/gc que
cubre cada datastore a la vez, donde antes tomaba una llamada
/admin/datastore/{store}/gc por datastore; esa llamada por datastore
permanece como respaldo cuando /admin/gc no está disponible — un PBS
más antiguo, o un privilegio faltante — y no se cuenta como un error.
/admin/gc también lleva la duración de ejecución y los contadores de
chunk que la llamada por datastore no tiene. gc_last_run_ok viene de
last-run-state en PBS 3.3 y posteriores; en versiones más antiguas
recurre a la tarea de recolección de basura más reciente de la
ventana. Los recuentos por tipo vienen de
/admin/datastore/{store}/status?verbose=1: sin verbose, PBS
devuelve solo los tamaños, que /status/datastore-usage ya daba.
/admin/datastore/{store}/namespace devuelve todo el árbol de
namespace, así que nada se pierde en sub-namespaces —
pve/site-a/rack1 se cuenta como la raíz. Los discos y pools vienen de
/nodes/localhost/disks/list y /nodes/localhost/disks/zfs (opción
disks; un 403 se tolera, igual que el 400 que un servidor sin ZFS
responde: sin serie de pool, sin error de sonda).
datastore_growth_percent_per_day es un ajuste de mínimos cuadrados
sobre el historial de uso que el propio PBS devuelve con
/status/datastore-usage: una fracción de uso entre 0 y 1, un punto
cada treinta minutos durante el último mes, con huecos null que se
omiten en lugar de rellenarse — un servidor que estuvo apagado no creció
mientras estuvo apagado. Estos son los mismos números detrás del propio
pronóstico «full in N days» de PBS. Se necesitan al menos ocho puntos
medidos antes de publicar nada, y datastore_history_days indica
cuánto historial cubre la pendiente. Un valor negativo no es un fallo:
el prune está recuperando más de lo que añaden las copias.
No se publica absolutamente nada para cinta cuando el servidor no tiene unidad, cambiador, pool ni job de cinta: una instalación sin cinta no debe hacer crecer una docena de series en cero que parezcan un nivel de cinta con problemas. Una cinta que no pertenece a ningún pool, medio en blanco o medio retirado de un pool, no está en ningún recuento de pool.
Dispositivos
Sección titulada «Dispositivos»Cada máquina respaldada — host, VM o contenedor — también se publica
bajo la familia genérica compartida por toda integración de DumbMonit
que rastrea dispositivos protegidos — dumbmonit_client_device_*, con
prefijo sin pbs, documentada por completo en Dispositivos
cliente. No se pide nada nuevo a
PBS: es la misma fecha de último snapshot ya detrás de
backup_last_timestamp_seconds, republicada bajo la familia compartida
para que una regla y una tabla sirvan a PBS junto a cualquier otra
integración que proteja un dispositivo.
| Métrica | Qué | Etiquetas |
|---|---|---|
last_backup_timestamp_seconds | El mismo instante que backup_last_timestamp_seconds para ese grupo | device, type, os, user, kind |
stale_seconds | Positivo una vez que un grupo ha superado device_stale_days (3 por defecto) sin un nuevo snapshot; impulsa la regla Client device stale | device, type, os, user, kind, signal (siempre backup) |
Límite que conviene conocer: PBS no registra una «conexión»
separada para una máquina respaldada, solo copias —
last_seen_timestamp_seconds y la señal connection nunca se publican
aquí; un dispositivo muestra last_connection como «—» en la tabla de
la página del monitor. El dispositivo nombrado en la alerta es el
nombre del invitado de las notas del snapshot cuando PVE escribió una,
si no type/id, igual que el calendario de copias.
Las reglas integradas que se aplican: Monitor unreachable, PBS datastore almost full, PBS datastore filling up, PBS backup too old (por grupo de copia: sin nuevo snapshot durante dos días — edita el umbral de la regla para una ventana más larga), PBS backup verification failed, PBS task failed, PBS garbage collection too old, PBS garbage collection failed, PBS corrupt chunks found, PBS sync job failed, PBS prune job failed, PBS verification job failed, PBS job never ran, PBS datastore not mounted, PBS service down, PBS restart pending after upgrade, PBS certificate expiring, PBS tape backup failed, PBS disk SMART failure, PBS SSD worn out, PBS ZFS pool degraded, PBS updates pending, Client device stale. Las notificaciones nombran el job, datastore o grupo de copia afectado.
Qué preparar en PBS
Sección titulada «Qué preparar en PBS»Los pasos de abajo son los que muestra el aviso junto al formulario. El principio: un usuario reservado para monitorización, un token con un rol de solo lectura — nunca la cuenta con la que inicias sesión.
-
Abre una shell en el servidor de copias (en la interfaz web: Administration → Shell; o SSH) y crea un usuario reservado para monitorización. No necesita contraseña: el token es lo que inicia sesión.
proxmox-backup-manager user create dumbmonit@pbs --comment "DumbMonit monitoring" -
Crea el token de API del usuario. El comando imprime el id del token y su secreto: copia ambos ahora, PBS nunca vuelve a mostrar el secreto.
proxmox-backup-manager user generate-token dumbmonit@pbs monitor -
Da el mínimo de solo lectura, por ruta — al token y al usuario que lo posee. Los privilegios efectivos de un token son la intersección de su propia ACL y la de su usuario: concedidos solo al token, no valen nada en absoluto, y PBS no lo reporta en ningún sitio. Cada línea por tanto se escribe dos veces.
DatastoreAuditen/datastore(Datastore.Audit) lee los datastores, snapshots, jobs de verify y prune y GC;Auditen/system(Sys.Audit) lee el estado del nodo, la lista de tareas y registros de tarea, los servicios, las reglas de control de tráfico, los discos y pools ZFS.proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs!monitor'Opcional, y también dos veces.
RemoteAuditen/remote(Remote.Audit) muestra los jobs de sync que obtienen de un remoto: el rol integradoAuditsolo cubreSys.AudityDatastore.Audit, y sinRemote.Audittal job no se rechaza, simplemente está ausente de la lista de jobs.TapeAuditen/tape(Tape.Audit) lee el nivel de cinta.Auditen/(Sys.Audita nivel raíz) lista las actualizaciones de paquete pendientes, y también cubre/datastorey/systemsi prefieres menos líneas. Sin ellos esos elementos se omiten en silencio, nada más cambia. Nada aquí puede escribir: el recolector solo realizaGETs.proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs!monitor' -
Antes de salir de la shell, comprueba qué puede leer realmente el token. El comando imprime sus privilegios efectivos, ruta por ruta; un resultado vacío significa que al usuario le falta la ACL que tiene el token — el caso en el que el dispositivo parece perfectamente vivo y no reporta nada.
proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' -
Copia el id del token en el campo Token ID de DumbMonit y el secreto en su campo Secret.
dumbmonit@pbs!monitor -
¿Prefieres la interfaz web? Configuration → Access Control: Users → Add, luego API Tokens → Add, luego Permissions → Add. Añade cada permiso dos veces, una vez como User Permission para
dumbmonit@pbsy otra como API Token Permission paradumbmonit@pbs!monitor: con ruta/datastorey rolDatastoreAudit, y de nuevo con ruta/systemy rolAudit. Un permiso de token por sí solo no concede nada. -
En DumbMonit, introduce la dirección del servidor, por ejemplo «pbs.lan» o «pbs.lan:8007».
Documentación del fabricante: PBS API tokens.
Credenciales
Sección titulada «Credenciales»| Credencial | Campos |
|---|---|
| Token de API (recomendado) | Token ID: usuario, reino y nombre de token tal como los muestra PBS, dumbmonit@pbs!monitor. Secret: el UUID mostrado una vez al crear el token. DumbMonit los envía como la cabecera PBSAPIToken=user@pbs!name:secret que espera PBS. |
| Nombre de usuario / contraseña | user@pbs (o @pam) y la contraseña. Se obtiene un ticket, se cachea y se renueva diez minutos antes de su caducidad de dos horas. |
La API acepta el token en dos piezas (token_id + secret) o, como
hacían las versiones antiguas, como una cadena token =
user@pbs!name=secret; ambas se guardan de la misma forma. Un token
completo pegado en Token ID se divide por el formulario.
Derechos, de solo lectura, y concedidos dos veces: los privilegios
efectivos de un token son la intersección de su propia ACL y la de su
usuario, así que cada rol de abajo debe darse a dumbmonit@pbs además
de a dumbmonit@pbs!monitor. El más simple: el rol integrado Audit
en /, más RemoteAudit en /remote para los jobs de sync y
TapeAudit en /tape para el nivel de cinta — Audit solo cubre
Sys.Audit y Datastore.Audit, y esos dos roles existen precisamente
porque no lo hace. Por endpoint:
| Endpoint | Necesita |
|---|---|
GET /version | cualquier usuario autenticado |
GET /nodes/localhost/status, GET /nodes/localhost/tasks, GET /nodes/localhost/tasks/{upid}/log | Sys.Audit en /system (Audit en /system) |
GET /nodes/localhost/disks/list, …/disks/smart, …/disks/zfs | Sys.Audit en /system (Audit en /system); un 403 se tolera: sin serie de disco, sin error de sonda. …/disks/zfs responde 400 en un servidor sin ZFS, tolerado de la misma forma |
GET /nodes/localhost/services, GET /admin/traffic-control | Sys.Audit en /system (Audit en /system); un 403 se tolera: sin serie, sin error de sonda |
GET /nodes/localhost/certificates/info | Sys.Modify en /system — un privilegio de escritura, por lo que la opción certificates está desactivada por defecto y por lo que no se espera que un token de monitorización lo tenga |
GET /status/datastore-usage, GET /admin/gc, GET /config/datastore, GET /admin/datastore/{store}/gc, …/status, …/active-operations, …/namespace, …/snapshots | Datastore.Audit en /datastore/{store} (DatastoreAudit en /datastore) |
GET /admin/verify, GET /admin/prune | listados para los datastores donde el token tiene Datastore.Audit; otros jobs se omiten en silencio |
GET /admin/sync | Datastore.Audit en el datastore y Remote.Audit en /remote/{remote} (RemoteAudit en /remote); otros jobs se omiten en silencio |
GET /nodes/localhost/apt/update, …/apt/versions | Sys.Audit en / (Audit en /); un 403 se tolera: sin serie de actualización o versión, sin error de sonda |
GET /tape/backup, /tape/drive, /tape/changer, /config/media-pool, /tape/media/list | Tape.Audit en /tape (TapeAudit en /tape); cada fallo se tolera, un PBS sin soporte de cinta incluido: sin serie de cinta, sin error de sonda |
Nota que Audit en /system solo no cubre la lista de actualizaciones,
que PBS comprueba en la ruta raíz. Un 403 en las listas de job o la
lista de actualizaciones se trata como un privilegio opcional: no se
produce nada y nada se cuenta en scrape_errors. Y un rol faltante en
el usuario es peor que un 403: la llamada tiene éxito y devuelve una
lista vacía, así que no se produce nada y tampoco se queja nada.
Dirección: 10.0.0.20, pbs.lan, pbs.lan:8007, [fd00::2] o una URL
completa. El esquema https y el puerto 8007 se añaden si faltan.
Opciones
Sección titulada «Opciones»| Clave | Etiqueta | Por defecto | Ayuda |
|---|---|---|---|
port | API port | 8007 | Se usa si la dirección no da un puerto. |
insecure_tls | Accept an unverifiable certificate | false | Proxmox Backup Server viene con un certificado autofirmado por defecto: activa esto si la conexión se rechaza por ese motivo. |
request_timeout_seconds | Timeout per request (seconds) | 15 | Tiempo permitido para cada llamada a la API, de 1 a 120. Listar los snapshots de un datastore grande puede tardar varios segundos. |
task_lookback_hours | Task window (hours) | 24 | Las tareas más antiguas no se cuentan entre los fallos, de 1 a 8760. |
datastores | Monitored datastores | (vacío) | Nombres de los datastores a monitorizar, separados por comas. Vacío: cada datastore. |
max_groups | Backup group limit | 500 | Número máximo de máquinas respaldadas que producen series; más allá, las más antiguas se ignoran. De 1 a 100000. |
jobs | Watch scheduled jobs | true | Lista los jobs de sync, verify y prune y su última ejecución (/admin/sync, /admin/verify, /admin/prune). |
updates | Watch pending updates | true | Cuenta los paquetes con actualización disponible (/nodes/localhost/apt/update). |
disks | Watch disks and ZFS pools | true | Lee los discos físicos (veredicto SMART, desgaste de SSD) y los pools ZFS (/nodes/localhost/disks). |
services | Watch the server’s services | true | Lee las unidades systemd y reporta si las que el servidor no puede evitar están en ejecución. Necesita Sys.Audit en /system; se omite en silencio en caso contrario. |
datastore_details | Read datastore detail | true | Dos llamadas más por datastore: cuántas máquinas y snapshots contiene, qué lo está leyendo o escribiendo ahora mismo, y si se retiene por mantenimiento. |
traffic_control | Watch traffic limits | true | Lee los límites de tasa y qué transportan ahora mismo. Necesita Sys.Audit; se omite en silencio en caso contrario. |
certificates | Watch certificate expiry | false | Desactivado por defecto: PBS protege esta llamada con Sys.Modify, un privilegio de escritura que no debería darse a un token de monitorización. |
tape | Watch tape backups | false | Lee el nivel de cinta. Desactivado por defecto, ya que la mayoría de instalaciones no tienen hardware de cinta. Necesita Tape.Audit en /tape. |
device_stale_days | Device staleness (days) | 3 | Una máquina respaldada sin un nuevo snapshot durante más de esto se reporta obsoleta. De 1 a 90. |
Errores comunes
Sección titulada «Errores comunes»| Síntoma | Causa probable |
|---|---|
| Error de certificado | Certificado autofirmado: instala uno de confianza (ACME está integrado en PBS) o activa insecure_tls. |
| Error de autenticación | El secret se pegó en Token ID (o al revés), o el token no tiene permiso Audit — con más frecuencia porque el rol se concedió al token pero no al usuario que lo posee, lo cual no falla: las llamadas tienen éxito y devuelven listas vacías. Solo GET /version fallando condena toda la sonda; cualquier otra llamada que falle se cuenta en scrape_errors. |
| Todo se lee vacío pero el monitor está activo | Al usuario le falta la ACL que tiene el token, y PBS intersecta los dos: proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' no imprime nada. Concede cada rol también a dumbmonit@pbs. |
Sin serie node_updates_pending | Al token le falta Sys.Audit en /: dale el rol Audit en /, o define updates como false para dejar de preguntar. |
| Falta un job de sync | Al token le falta Remote.Audit en el remoto del job: añade el rol RemoteAudit en /remote. El job no se rechaza, simplemente está ausente de la lista. |
| Sin caducidad de certificado | La opción certificates está desactivada, que es lo por defecto: PBS requiere Sys.Modify para esa llamada, un privilegio de escritura. |
| El panel Tape nunca aparece | La opción tape está desactivada, que es lo por defecto, o el servidor no tiene unidad, cambiador, pool ni job de cinta. No se publica nada cuando no hay nada. |
| Sin cifra de crecimiento en un datastore | El historial de uso de PBS tiene menos de ocho puntos medidos; se rellena en los primeros días. |
| «PBS datastore filling up» nunca se activa | datastore_estimated_full_seconds lo calcula PBS a partir de un mes de mediciones y está ausente hasta entonces. |
| Faltan grupos | Más de max_groups máquinas respaldadas: backup_groups_dropped indica cuántas se excluyeron. |
| El calendario está vacío o corto | Se rellena desde la lista de tareas en la primera sonda tras un inicio (últimos 30 días); un PBS cuyo archivo de tareas se limpió muestra solo lo que queda. Una máquina que nunca se respaldó en este servidor y nunca tuvo una tarea no tiene fila. |
Una máquina se muestra como vm/104 sin su nombre | PVE escribe el nombre del invitado en las notas del snapshot solo con la plantilla de notas por defecto ({{guestname}}); una plantilla personalizada o un PVE más antiguo deja las notas vacías. |
| «Show log» falla | Al token le falta Sys.Audit en /system para el registro de tarea, o PBS ya rotó el registro de una tarea antigua. |