
Proxmox Backup Server
Serveur de sauvegarde : un calendrier de sauvegarde sur trente jours par machine, tâches en échec avec leurs journaux, jobs planifiés (sync, verify, prune, ramasse-miettes), datastores, disques et pools ZFS, mises à jour en attente, les services et versions de paquet du serveur lui-même, et le niveau bande quand il y en a un.
Ports réseau à ouvrir
Section intitulée « Ports réseau à ouvrir »Du serveur DumbMonit (ou de son agent relais) vers l’équipement :
| Port | Protocole | Usage |
|---|---|---|
| 8007 | TCP | API (HTTPS, par défaut) |
La page de la surveillance
Section intitulée « La page de la surveillance »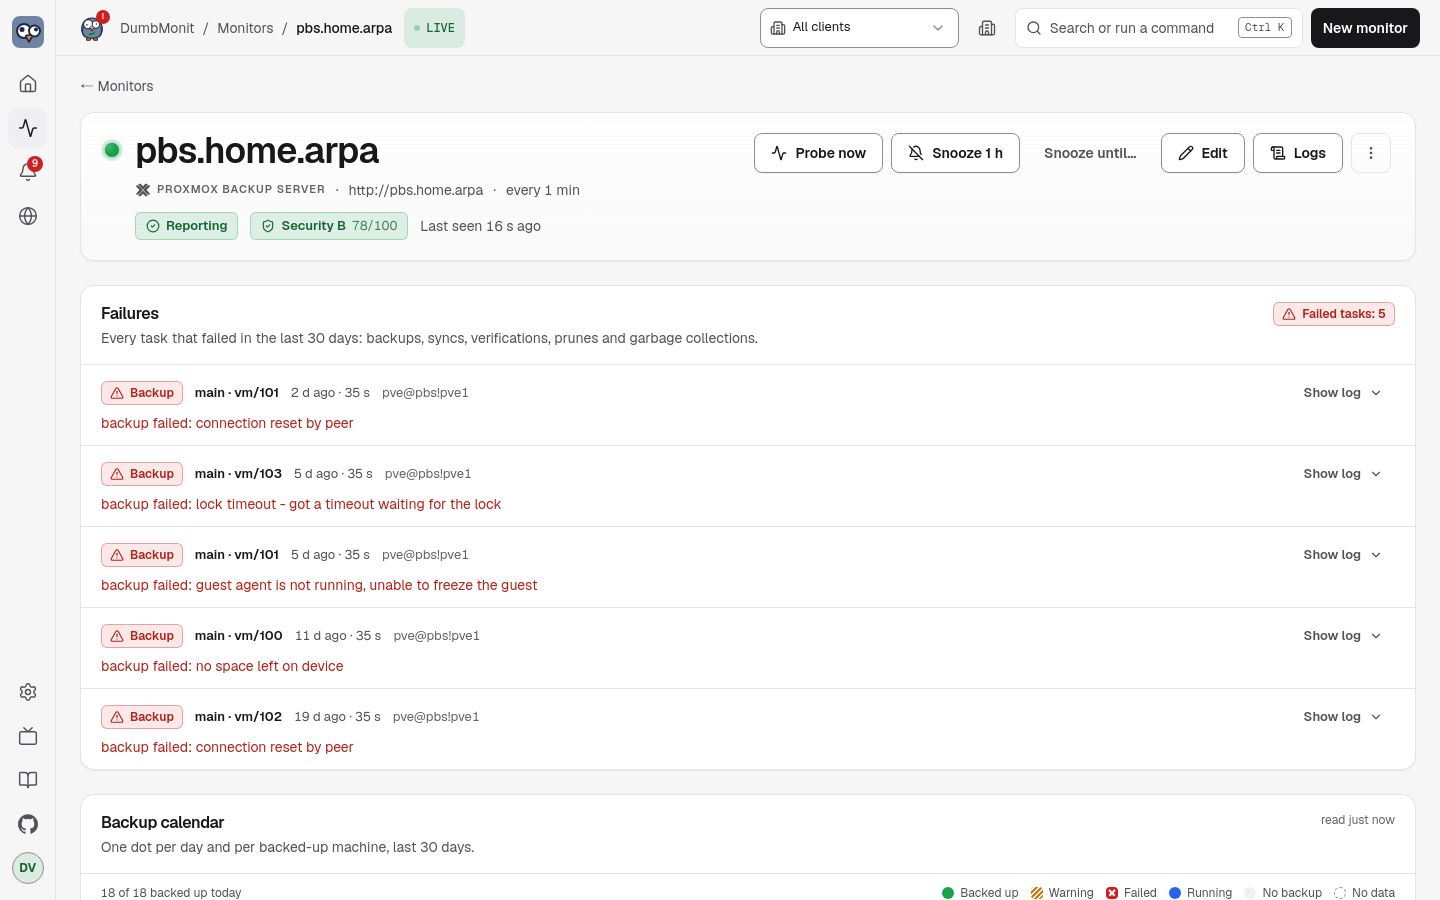
Au-delà des graphiques génériques, une surveillance PBS montre six panneaux, lus depuis ce que la sonde a stocké — ouvrir la page n’interroge jamais PBS lui-même :
- Échecs — chaque tâche qui a échoué dans les 30 derniers jours
(backup, sync, verify, prune, GC), la plus récente d’abord, avec son
type, ce qu’elle visait, quand elle a commencé et le propre message
d’erreur de PBS. Montrer le journal récupère les dernières lignes du
journal de tâche depuis PBS à la demande
(
/nodes/localhost/tasks/{upid}/log). - Calendrier de sauvegarde — une ligne par machine sauvegardée
(datastore, namespace,
type/id, et le nom de l’invité quand PVE l’a écrit dans les notes de snapshot), un point par jour : teal quand une sauvegarde a réussi ce jour (une tâche s’est terminéeOK, ou un snapshot existe — les groupes synchronisés n’ont pas de tâche locale), rouge quand une tâche de sauvegarde a échoué et qu’aucune n’a réussi, ambre quand la sauvegarde est là mais que sa vérification a échoué, bleu pendant qu’une tourne, gris quand rien ne s’est passé. L’infobulle de chaque point donne l’heure, la taille, la durée et un extrait d’erreur ; la ligne dit quand le dernier succès et le dernier échec ont eu lieu, le nombre de snapshots, la taille du dernier snapshot et la rétention du job prune qui s’applique. Une machine dont toutes les sauvegardes échouent n’a aucun snapshot du tout et apparaît quand même — depuis ses tâches. - Jobs — chaque job sync, verify et prune et le GC de chaque datastore, avec calendrier, dernière exécution, résultat, prochaine exécution ; une dernière exécution en échec obtient une plaque rouge et le texte d’erreur, les échecs se trient en premier.
- Bande — seulement quand le serveur a un niveau bande. Jobs de sauvegarde sur bande avec leur pool, lecteur, l’étiquette de la prochaine bande attendue, la dernière exécution et son erreur ; pools de médias avec leurs politiques d’allocation et de rétention, combien de bandes ils contiennent, combien ont expiré et si elles sont chiffrées ; lecteurs et changeurs ; et les bandes elles-mêmes avec leur statut, leur jeu de médias, leur emplacement et leurs octets écrits.
- Datastores et disques — barre d’usage, la propre prévision de
remplissage de PBS, facteur de déduplication, dernier GC ; pools ZFS
avec leur santé ; disques physiques avec le verdict SMART et l’usure
SSD, et le tableau SMART complet à la demande
(
/nodes/localhost/disks/smart). Par datastore, il montre aussi une plaque maintenance ou « Non monté », une plaque « Occupé : n écritures, n lectures », la croissance mesurée par jour et sur combien de jours d’historique, combien de machines de chaque type il contient, combien de temps le dernier GC a pris, et une ligne d’avertissement quand ce GC a trouvé des chunks illisibles. - Serveur — les unités systemd, avec celles dont le serveur ne peut pas se passer signalées ; les versions de paquet Proxmox (installée, disponible, en cours), avec une plaque « Redémarrage en attente » quand le démon est en retard sur son paquet ; le certificat et son expiration ; et les règles de contrôle de trafic avec leurs plafonds et ce qu’elles transportent.
Le calendrier découpe les jours à minuit heure locale du navigateur. Son
historique vient de la liste de tâches : la première sonde après un
démarrage lit les 30 derniers jours
(/nodes/localhost/tasks?since=…&limit=5000), les sondes suivantes
seulement la fenêtre de tâches, et le serveur garde l’union dans SQLite
(pbs_task_history, 35 jours, 10 000 tâches au plus par surveillance) pour
que le calendrier survive aux redémarrages.
Ce qu’il surveille
Section intitulée « Ce qu’il surveille »Toutes les métriques sont préfixées dumbmonit_pbs_.
| Famille | Métriques | Labels |
|---|---|---|
| Nœud | node_cpu_percent, node_cpu_count, node_iowait_percent (temps CPU attendant l’E/S — sur un serveur de sauvegarde c’est ce qui dit que les disques sont saturés), node_load1/5/15, node_memory_used/total/free_bytes, node_memory_used_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_uptime_seconds, node_kernel_info, version_info | |
| Datastores | datastore_available, datastore_bytes_used/total/avail, datastore_used_percent, datastore_estimated_full_seconds (propre estimation de PBS ; absent tant qu’il manque de données ou que l’usage diminue), datastore_dedup_factor, datastore_removable_unmounted (1 quand un datastore amovible est notmounted — pas une erreur, il n’est simplement pas branché ; label mount_status), datastore_backend_info (label backend, filesystem ou s3), datastore_maintenance (1 quand le datastore est tenu en maintenance ; label mode, offline, read-only…), datastore_groups et datastore_snapshots (label type, vm/ct/host/other), datastore_active_reads, datastore_active_writes (ce qui tient le datastore en ce moment — c’est ce qui explique un ramasse-miettes qui ne se termine pas), datastore_growth_percent_per_day, datastore_growth_bytes_per_day, datastore_history_days | datastore |
| Ramasse-miettes | gc_last_removed_bytes, gc_last_pending_bytes, gc_last_run_ok (PBS 3.3+), gc_last_success_age_seconds, gc_last_duration_seconds, gc_disk_chunks, gc_last_pending_chunks, gc_last_removed_chunks, gc_bad_chunks (chunks que le GC a trouvés illisibles et laissés en place — de la corruption, pas de l’espace à récupérer : une sauvegarde qui les référence ne peut plus être restaurée), verify_last_success_age_seconds, sync_last_success_age_seconds | datastore |
| Groupes de sauvegarde | backup_count, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_last_verified (1 vérifié, 0 échoué, absent si jamais vérifié) | datastore, namespace, backup_type, group |
| Namespaces | namespace_groups, namespace_snapshots (le namespace racine est namespace="") | datastore, namespace |
| Tâches dans la fenêtre | tasks_running, tasks_ok, tasks_failed | worktype (backup, verificationjob, garbage_collection, prune, syncjob…) |
| Jobs | job_enabled, job_last_ok (1 pour OK ou WARNINGS: n, 0 sinon, absent si le job n’a jamais tourné), job_never_run (1 quand un job est activé, a un calendrier et n’a jamais tourné — il n’a ni échec ni succès, il est donc invisible partout ailleurs), job_last_run_age_seconds, job_next_run_seconds (négatif en retard), sync_jobs_total, verify_jobs_total, prune_jobs_total ; alias sync_job_last_ok pour la règle | job, datastore, kind (sync, verify, prune) ; remote (remote:remote-store, ou local) sur les jobs sync — l’alias porte job, datastore, remote |
Bande (option tape, désactivée par défaut, cinq appels) | tape_backup_job_last_ok, tape_backup_job_never_run, tape_backup_job_last_run_age_seconds, tape_backup_job_next_run_seconds, tape_backup_jobs_total ; tape_drive_info (série de présence), tape_drives_total, tape_changers_total, tape_media_pools_total ; tape_media_total, tape_media_writable, tape_media_expired, tape_media_bytes_used | job, datastore, pool, drive sur les jobs ; drive, vendor, model, changer sur tape_drive_info ; pool sur les compteurs de média |
| Disques (mêmes noms que Proxmox VE) | node_disk_size_bytes, node_disk_smart_failed (0 passed, 1 failed ; absent quand SMART n’a donné aucun verdict), node_disk_health_info (série de présence ; labels health, serial, used), node_disk_wearout_percent (endurance utilisée, SSD seulement, comme PBS l’affiche : 100 − wearout) | disk (/dev/sda), model, type |
| Pools ZFS (mêmes noms que Proxmox VE) | node_zfs_pool_degraded (0 ONLINE, 1 sinon), node_zfs_pool_health_info (label health), node_zfs_pool_size_bytes, node_zfs_pool_alloc_bytes, node_zfs_pool_free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | pool |
| Mises à jour | node_updates_pending (nombre de paquets avec une mise à jour disponible) | |
Versions (option updates, depuis /nodes/localhost/apt/versions) | node_package_upgradable (1/0), node_package_info (série de présence ; labels installed, available, running), node_running_version_stale (1 quand le paquet proxmox-backup-server installé n’est plus le démon en cours — le paquet a été mis à niveau, les services n’ont pas été redémarrés) | package, restreint à proxmox-backup, proxmox-backup-server, proxmox-backup-client, proxmox-kernel-helper |
Services (option services, un appel) | node_service_active (1 en cours, 0 non), node_service_enabled (absent pour une unité static, qu’une autre unité entraîne et qui n’est donc ni activée ni désactivée), node_services_total | service, expected ("1" pour proxmox-backup, proxmox-backup-proxy et proxmox-backup-banner, les unités dont le serveur ne peut pas se passer ; chaque autre unité obtient quand même sa série, avec expected="0", et ne déclenche jamais d’alerte) |
Certificat (option certificates, désactivée par défaut) | node_certificate_expires_seconds, négatif une fois expiré | certificate (le nom de fichier), issuer |
Contrôle de trafic (option traffic_control) | traffic_rate_in_bytes, traffic_rate_out_bytes (mesuré à l’instant de la sonde), traffic_limit_in_bytes, traffic_limit_out_bytes (le plafond configuré, analysé depuis les chaînes décimales de PBS comme 100 MB ; absent quand cette direction est sans plafond, plutôt qu’un zéro qui se lirait comme « tout est bloqué »), traffic_rules_total | rule |
| Options sautées | feature_skipped_info : 1 tant qu’un appel facultatif est refusé (403) faute de droit, absente sinon. La page du moniteur l’affiche en note discrète qui nomme le droit ; ce n’est ni une erreur de sonde ni une alerte | feature, privilege |
| Limites et collection | backup_groups_total, backup_groups_dropped, up, scrape_errors, scrape_duration_seconds |
Une tâche qui se termine en WARNINGS: n compte comme réussie. Les
appels par datastore sont limités à quatre en parallèle : lister les
snapshots lit les index du datastore, et une rafale ralentirait la
sauvegarde en cours.
Les listes de jobs ne sont pas limitées à la fenêtre de tâches : un job
sync qui échoue depuis trois semaines est toujours rapporté comme en
échec. Un job qui n’a jamais tourné n’a pas de série job_last_ok, mais
il obtient job_never_run, et la règle « job PBS jamais exécuté » se
déclenche exactement sur ce cas.
Le ramasse-miettes est lu avec un seul appel /admin/gc couvrant chaque
datastore d’un coup, là où il fallait un /admin/datastore/{store}/gc
par datastore avant ; cet appel par datastore reste comme repli quand
/admin/gc n’est pas disponible — un PBS plus ancien, ou un privilège
manquant — et n’est pas compté comme une erreur. /admin/gc porte aussi
la durée d’exécution et les compteurs de chunks que l’appel par
datastore ne donne pas. gc_last_run_ok vient de last-run-state sur
PBS 3.3 et plus récent ; sur les versions plus anciennes, il se replie
sur la tâche de ramasse-miettes la plus récente de la fenêtre. Les
compteurs par type viennent de
/admin/datastore/{store}/status?verbose=1 : sans verbose, PBS ne
renvoie que les tailles, que /status/datastore-usage donnait déjà.
/admin/datastore/{store}/namespace renvoie tout l’arbre de namespace,
rien n’est donc perdu dans les sous-namespaces — pve/site-a/rack1 est
compté comme la racine. Disques et pools viennent de
/nodes/localhost/disks/list et /nodes/localhost/disks/zfs (option
disks ; un 403 est toléré, comme le 400 qu’un serveur sans ZFS
répond : pas de série de pool, pas d’erreur de sonde).
datastore_growth_percent_per_day est un ajustement par moindres carrés
sur l’historique d’usage que PBS renvoie lui-même avec
/status/datastore-usage : une fraction d’usage entre 0 et 1, un
point toutes les trente minutes sur le dernier mois, avec des trous
null qui sont sautés plutôt que remplis — un serveur éteint n’a pas
grandi pendant qu’il était éteint. Ce sont les mêmes chiffres derrière la
propre prévision « plein dans N jours » de PBS. Au moins huit points
mesurés sont nécessaires avant que rien ne soit publié, et
datastore_history_days dit combien d’historique la pente couvre. Une
valeur négative n’est pas une panne : le prune récupère plus que les
sauvegardes n’ajoutent.
Rien du tout n’est publié pour la bande quand le serveur n’a pas de lecteur, pas de changeur, pas de pool et pas de job bande : une installation sans bande ne doit pas faire grandir une douzaine de séries à zéro qui se liraient comme un niveau bande en difficulté. Une bande qui n’appartient à aucun pool, un média vierge ou retiré d’un pool, n’est dans aucun compteur de pool.
Appareils
Section intitulée « Appareils »Chaque machine sauvegardée — hôte, VM ou conteneur — est aussi publiée
sous la famille générique partagée par chaque intégration DumbMonit qui
suit les appareils protégés — dumbmonit_client_device_*, préfixée sans
pbs, documentée en entier sous
Appareils clients. Rien de
nouveau n’est demandé à PBS : c’est la même date de dernier snapshot déjà
derrière backup_last_timestamp_seconds, republiée sous la famille
partagée pour qu’une règle et un tableau servent PBS avec chaque autre
intégration qui protège un appareil.
| Métrique | Quoi | Labels |
|---|---|---|
last_backup_timestamp_seconds | Même instant que backup_last_timestamp_seconds pour ce groupe | device, type, os, user, kind |
stale_seconds | Positif une fois qu’un groupe a dépassé device_stale_days (3 par défaut) sans nouveau snapshot ; alimente la règle Appareil client périmé | device, type, os, user, kind, signal (toujours backup) |
Limite à connaître : PBS n’enregistre pas de « connexion » séparée
pour une machine sauvegardée, seulement des sauvegardes —
last_seen_timestamp_seconds et le signal connection ne sont jamais
publiés ici ; un appareil montre last_connection comme « — » dans le
tableau de la page de la surveillance. L’appareil nommé dans l’alerte est le
nom de l’invité depuis les notes de snapshot quand PVE en a écrit une,
sinon type/id, comme le calendrier de sauvegarde.
Règles intégrées qui s’appliquent : Surveillance inaccessible, datastore PBS presque plein, datastore PBS qui se remplit, sauvegarde PBS trop ancienne (par groupe de sauvegarde : pas de nouveau snapshot depuis deux jours — modifiez le seuil de la règle pour une fenêtre plus longue), vérification de sauvegarde PBS échouée, tâche PBS échouée, ramasse-miettes PBS trop ancien, ramasse-miettes PBS échoué, chunks corrompus PBS trouvés, job sync PBS échoué, job prune PBS échoué, job de vérification PBS échoué, job PBS jamais exécuté, datastore PBS non monté, service PBS arrêté, redémarrage PBS en attente après mise à niveau, certificat PBS arrivant à expiration, sauvegarde sur bande PBS échouée, échec SMART de disque PBS, SSD PBS usé, pool ZFS PBS dégradé, mises à jour PBS en attente, appareil client périmé. Les notifications nomment le job, le datastore ou le groupe de sauvegarde concerné.
Ce qu’il faut préparer dans PBS
Section intitulée « Ce qu’il faut préparer dans PBS »-
Ouvrez Configuration → Access Control → User Management → Add, saisissez le nom d’utilisateur dumbmonit, choisissez le realm Proxmox Backup authentication server, puis cliquez sur Add.
dumbmonit@pbs -
Ouvrez Configuration → Access Control → API Token → Add : utilisateur dumbmonit@pbs, nom du jeton monitor. Copiez maintenant le Token ID et le Secret, le secret n’est affiché qu’une seule fois.
dumbmonit@pbs!monitor -
Ouvrez Configuration → Access Control → Permissions → Add → User Permission : chemin /, utilisateur dumbmonit@pbs, rôle Audit.
-
Ajoutez une seconde permission avec Add → API Token Permission : chemin /, jeton dumbmonit@pbs!monitor, rôle Audit. Un jeton a ses propres permissions, il faut donc les deux.
-
Facultatif, pour voir les jobs de synchronisation en pull et le palier bandes : répétez les deux permissions avec le rôle RemoteAudit sur le chemin /remote et le rôle TapeAudit sur le chemin /tape.
-
Dans DumbMonit, saisissez l’adresse du serveur (par exemple pbs.lan:8007), le Token ID et le Secret.
Droits requis
Section intitulée « Droits requis »- Audit sur / : Lecture seule : datastores, snapshots, tâches, état du nœud
- RemoteAudit sur /remote (facultatif) : Affiche les jobs de synchronisation qui tirent depuis un remote
- TapeAudit sur /tape (facultatif) : Lit le palier bandes
- Sys.Modify sur /system/certificates (facultatif) : Seulement pour l’option d’expiration des certificats
Documentation de l’éditeur : PBS API tokens
Pourquoi ces droits
Section intitulée « Pourquoi ces droits »Ne réutilisez pas le compte avec lequel vous vous connectez : un jeton
divulgué gérerait toutes les sauvegardes. Le rôle Audit ne sait que lire.
AuditvautSys.AuditplusDatastore.Audit. Sur/, il lit les datastores, les snapshots, les jobs de vérification et de prune et le GC, l’état du nœud, la liste des tâches et leurs journaux, les services, les règles de traffic-control, les disques et les pools ZFS, ainsi que les mises à jour de paquets en attente. Rien ici ne peut écrire : le collecteur ne fait que desGET.- Les privilèges effectifs d’un jeton sont l’intersection de sa propre ACL et de celle de son utilisateur. Accordés au seul jeton, ils ne valent rien, et PBS ne le signale nulle part. Chaque permission est donc ajoutée deux fois, pour l’utilisateur et pour le jeton.
RemoteAuditsur/remote(Remote.Audit) montre les jobs de synchronisation qui tirent depuis un remote : le rôle intégréAuditne couvre pasRemote.Audit, et sans lui un tel job n’est pas refusé, il est simplement absent de la liste.TapeAuditsur/tape(Tape.Audit) lit le palier bandes. Sans eux, ces éléments sont ignorés sans bruit, le reste ne change pas.- PBS utilise par défaut un certificat auto-signé : si la connexion est refusée pour cette raison, cochez « Accepter un certificat non vérifiable » dans les options.
Pour vérifier ce que le jeton peut réellement lire, lancez ceci sur le serveur de sauvegarde (Administration → Shell). La commande affiche les privilèges effectifs, chemin par chemin ; un résultat vide signifie qu’il manque à l’utilisateur la permission qu’a le jeton — le cas où l’appareil semble vivant et ne remonte rien.
proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor'Vous préférez un shell pour toute la configuration ?
proxmox-backup-manager user create dumbmonit@pbs --comment "DumbMonit monitoring"proxmox-backup-manager user generate-token dumbmonit@pbs monitorproxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs!monitor'Identifiants
Section intitulée « Identifiants »| Identifiant | Champs |
|---|---|
| Jeton d’API (recommandé) | Token ID : utilisateur, domaine et nom de jeton comme PBS les montre, dumbmonit@pbs!monitor. Secret : l’UUID montré une fois à la création du jeton. DumbMonit les envoie comme l’en-tête PBSAPIToken=user@pbs!name:secret que PBS attend. |
| Nom d’utilisateur / mot de passe | user@pbs (ou @pam) et le mot de passe. Un ticket est obtenu, mis en cache et renouvelé dix minutes avant son expiration de deux heures. |
L’API accepte le jeton en deux morceaux (token_id + secret) ou,
comme le faisaient les anciennes versions, comme une seule chaîne
token = user@pbs!name=secret ; les deux sont stockés de la même
façon. Un jeton entier collé dans Token ID est découpé par le
formulaire.
Droits, en lecture seule, et accordés deux fois : les privilèges
effectifs d’un jeton sont l’intersection de sa propre ACL et de celle de
son utilisateur, chaque rôle ci-dessous doit donc être donné à
dumbmonit@pbs ainsi qu’à dumbmonit@pbs!monitor. Le plus simple : le
rôle intégré Audit sur /, plus RemoteAudit sur /remote pour les
jobs sync et TapeAudit sur /tape pour le niveau bande — Audit ne
couvre que Sys.Audit et Datastore.Audit, et ces deux rôles existent
précisément parce qu’il ne les couvre pas. Par point de terminaison :
| Point de terminaison | A besoin de |
|---|---|
GET /version | tout utilisateur authentifié |
GET /nodes/localhost/status, GET /nodes/localhost/tasks, GET /nodes/localhost/tasks/{upid}/log | Sys.Audit sur /system (Audit sur /system) |
GET /nodes/localhost/disks/list, …/disks/smart, …/disks/zfs | Sys.Audit sur /system (Audit sur /system) ; un 403 est toléré : pas de série de disque, pas d’erreur de sonde. …/disks/zfs répond 400 sur un serveur sans ZFS, toléré de la même façon |
GET /nodes/localhost/services, GET /admin/traffic-control | Sys.Audit sur /system (Audit sur /system) ; un 403 est toléré : pas de série, pas d’erreur de sonde |
GET /nodes/localhost/certificates/info | Sys.Modify sur /system — un privilège d’écriture, c’est pourquoi l’option certificates est désactivée par défaut et pourquoi un jeton de surveillance n’est pas censé l’avoir |
GET /status/datastore-usage, GET /admin/gc, GET /config/datastore, GET /admin/datastore/{store}/gc, …/status, …/active-operations, …/namespace, …/snapshots | Datastore.Audit sur /datastore/{store} (DatastoreAudit sur /datastore) |
GET /admin/verify, GET /admin/prune | listés pour les datastores où le jeton a Datastore.Audit ; les autres jobs sont omis en silence |
GET /admin/sync | Datastore.Audit sur le datastore et Remote.Audit sur /remote/{remote} (RemoteAudit sur /remote) ; les autres jobs sont omis en silence |
GET /nodes/localhost/apt/update, …/apt/versions | Sys.Audit sur / (Audit sur /) ; un 403 est toléré : pas de série de mise à jour ou de version, pas d’erreur de sonde |
GET /tape/backup, /tape/drive, /tape/changer, /config/media-pool, /tape/media/list | Tape.Audit sur /tape (TapeAudit sur /tape) ; chaque échec est toléré, un PBS sans support de bande inclus : pas de série de bande, pas d’erreur de sonde |
Notez que Audit sur /system seul ne couvre pas la liste de mises à
jour, que PBS vérifie au chemin racine. Un 403 sur les listes de jobs ou
la liste de mises à jour est traité comme un privilège optionnel : rien
n’est produit et rien n’est compté dans scrape_errors. Et un rôle
manquant sur l’utilisateur est pire qu’un 403 : l’appel réussit et
renvoie une liste vide, rien n’est donc produit et rien ne se plaint non
plus.
Adresse : 10.0.0.20, pbs.lan, pbs.lan:8007, [fd00::2] ou une URL
complète. Le schéma https et le port 8007 sont ajoutés s’ils manquent.
| Clé | Libellé | Défaut | Aide |
|---|---|---|---|
port | Port de l’API | 8007 | Utilisé si l’adresse ne donne pas de port. |
insecure_tls | Accepter un certificat non vérifiable | false | Proxmox Backup Server livre un certificat autosigné par défaut : activez ceci si la connexion est refusée pour cette raison. |
request_timeout_seconds | Délai par requête (secondes) | 15 | Temps accordé à chaque appel d’API, de 1 à 120. Lister les snapshots d’un grand datastore peut prendre plusieurs secondes. |
task_lookback_hours | Fenêtre de tâches (heures) | 24 | Les tâches plus anciennes ne sont pas comptées parmi les échecs, de 1 à 8760. |
datastores | Datastores surveillés | (vide) | Noms des datastores à surveiller, séparés par des virgules. Vide : chaque datastore. |
max_groups | Limite de groupe de sauvegarde | 500 | Nombre maximum de machines sauvegardées produisant des séries ; au-delà, les plus anciennes sont ignorées. De 1 à 100000. |
jobs | Surveiller les jobs planifiés | true | Liste les jobs sync, verify et prune et leur dernière exécution (/admin/sync, /admin/verify, /admin/prune). |
updates | Surveiller les mises à jour en attente | true | Compte les paquets avec une mise à jour disponible (/nodes/localhost/apt/update). |
disks | Surveiller les disques et pools ZFS | true | Lit les disques physiques (verdict SMART, usure SSD) et les pools ZFS (/nodes/localhost/disks). |
services | Surveiller les services du serveur | true | Lit les unités systemd et rapporte si celles dont le serveur ne peut pas se passer tournent. A besoin de Sys.Audit sur /system ; ignoré en silence sinon. |
datastore_details | Lire le détail du datastore | true | Deux appels de plus par datastore : combien de machines et snapshots il contient, ce qui le lit ou l’écrit en ce moment, et s’il est tenu en maintenance. |
traffic_control | Surveiller les limites de trafic | true | Lit les limites de débit et ce qu’elles transportent en ce moment. A besoin de Sys.Audit ; ignoré en silence sinon. |
certificates | Surveiller l’expiration des certificats | false | Désactivé par défaut : PBS protège cet appel derrière Sys.Modify, un privilège d’écriture qu’un jeton de surveillance ne devrait pas avoir. |
tape | Surveiller les sauvegardes sur bande | false | Lit le niveau bande. Désactivé par défaut, puisque la plupart des installations n’ont pas de matériel bande. A besoin de Tape.Audit sur /tape. |
device_stale_days | Péremption d’appareil (jours) | 3 | Une machine sauvegardée sans nouveau snapshot depuis plus longtemps que ça est rapportée périmée. De 1 à 90. |
Erreurs courantes
Section intitulée « Erreurs courantes »| Symptôme | Cause probable |
|---|---|
| Erreur de certificat | Certificat autosigné : installez-en un de confiance (ACME est intégré à PBS) ou activez insecure_tls. |
| Erreur d’authentification | Le secret collé dans Token ID (ou l’inverse), ou le jeton n’a pas de permission Audit — le plus souvent parce que le rôle a été accordé au jeton mais pas à l’utilisateur qui le possède, ce qui n’échoue pas : les appels réussissent et renvoient des listes vides. Seul l’échec de GET /version condamne toute la sonde ; tout autre appel en échec est compté dans scrape_errors. |
| Tout se lit vide mais la surveillance est active | L’utilisateur manque l’ACL que le jeton a, et PBS fait l’intersection des deux : proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' n’affiche rien. Accordez chaque rôle à dumbmonit@pbs aussi. |
Aucune série node_updates_pending | Le jeton manque Sys.Audit sur / : donnez-lui le rôle Audit sur /, ou réglez updates sur false pour arrêter de demander. |
| Un job sync manque | Le jeton manque Remote.Audit sur le remote du job : ajoutez le rôle RemoteAudit sur /remote. Le job n’est pas refusé, il est simplement absent de la liste. |
| Aucune expiration de certificat | L’option certificates est désactivée, ce qui est le défaut : PBS exige Sys.Modify pour cet appel, un privilège d’écriture. |
| Le panneau Bande n’apparaît jamais | L’option tape est désactivée, ce qui est le défaut, ou le serveur n’a aucun lecteur, changeur, pool ou job bande. Rien n’est publié quand il n’y a rien. |
| Aucun chiffre de croissance sur un datastore | L’historique d’usage de PBS a moins de huit points mesurés ; il se remplit sur les premiers jours. |
| « Datastore PBS qui se remplit » ne se déclenche jamais | datastore_estimated_full_seconds est calculé par PBS depuis un mois de mesures et est absent jusque là. |
| Groupes manquants | Plus de max_groups machines sauvegardées : backup_groups_dropped dit combien ont été laissées de côté. |
| Le calendrier est vide ou court | Il se remplit depuis la liste de tâches à la première sonde après un démarrage (30 derniers jours) ; un PBS dont l’archive de tâches a été nettoyée ne montre que ce qui reste. Une machine jamais sauvegardée sur ce serveur et sans jamais de tâche n’a pas de ligne. |
Une machine se montre comme vm/104 sans son nom | PVE n’écrit le nom de l’invité dans les notes de snapshot qu’avec le modèle de notes par défaut ({{guestname}}) ; un modèle personnalisé ou un PVE plus ancien laisse les notes vides. |
| « Montrer le journal » échoue | Le jeton manque Sys.Audit sur /system pour le journal de tâche, ou PBS a déjà roté le journal d’une vieille tâche. |