
Proxmox VE
Hyperviseur : nœuds avec leurs démons et réseau, machines virtuelles, conteneurs, stockages, pools LVM thin, sauvegardes, haute disponibilité, snapshots, réplication, Ceph jusqu’à l’OSD, disques physiques et pools ZFS, mises à jour en attente, changements de paquet, abonnement et certificats. Une surveillance peut couvrir tout un cluster.
Ports réseau à ouvrir
Section intitulée « Ports réseau à ouvrir »Du serveur DumbMonit (ou de son agent relais) vers l’équipement :
| Port | Protocole | Usage |
|---|---|---|
| 8006 | TCP | API (HTTPS, par défaut) |
Le panneau des nœuds
Section intitulée « Le panneau des nœuds »La page de la surveillance s’ouvre sur une carte par nœud : CPU, mémoire et
système de fichiers racine comme trois jauges, l’uptime et la version
pve-manager installée sur ce nœud, puis seulement ce qui ne va pas —
les démons qui ne tournent pas, les interfaces déclarées au démarrage
qui ne sont pas actives — et le remplissage de chaque pool thin LVM et
groupe de volumes. Un nœud qui a arrêté de répondre garde sa carte et
lit hors ligne.
Deux lignes sous les jauges, quand le nœud les rapporte : la part de temps CPU passée à attendre le stockage (I/O wait — un nœud à 10 % de CPU et 30 % d’I/O wait n’a plus de marge, et aucun autre chiffre ne le dit) et la mémoire que KSM a récupérée en partageant des pages identiques entre invités, ce qui fait qu’un nœud héberge plus que sa RAM.
Deux entrées de plus rejoignent la liste « ce qui ne va pas », les deux en mots :
- Redémarrage requis — un noyau plus récent est installé que celui
en cours. La carte nomme les deux versions, puisque le nœud continue
de faire tourner l’ancien jusqu’à ce qu’il soit redémarré. Ça vient de
/nodes/{node}/apt/versions, qui n’a besoin que deSys.Audit; - Mises à jour en attente — combien de paquets Proxmox ont une
version candidate plus récente, depuis le même appel. Ce n’est pas la
même chose que
apt/update, qui compte chaque paquet en attente du système mais a besoin deSys.Modifyet est généralement refusé.
Quand le cluster rapporte un watchdog HA (Proxmox VE 9 et plus récent), son état est indiqué à côté du titre du panneau : HA fencing armé une fois que des ressources sont données à HA, HA fencing en veille tandis qu’aucune ne le sont — dans ce cas aucun nœud ne sera isolé, ce qui est normal mais vaut la peine d’être su avant de compter là-dessus.
Un cluster mis à niveau nœud par nœud le montre ici : /version répond
pour le nœud qui a été interrogé, chaque carte porte donc sa propre
version et un retardataire est visible sans ouvrir un shell.
La donnée vient de GET /api/targets/{id}/proxmox/nodes, lue depuis la
dernière sonde dans le magasin de métriques.
Le panneau des invités
Section intitulée « Le panneau des invités »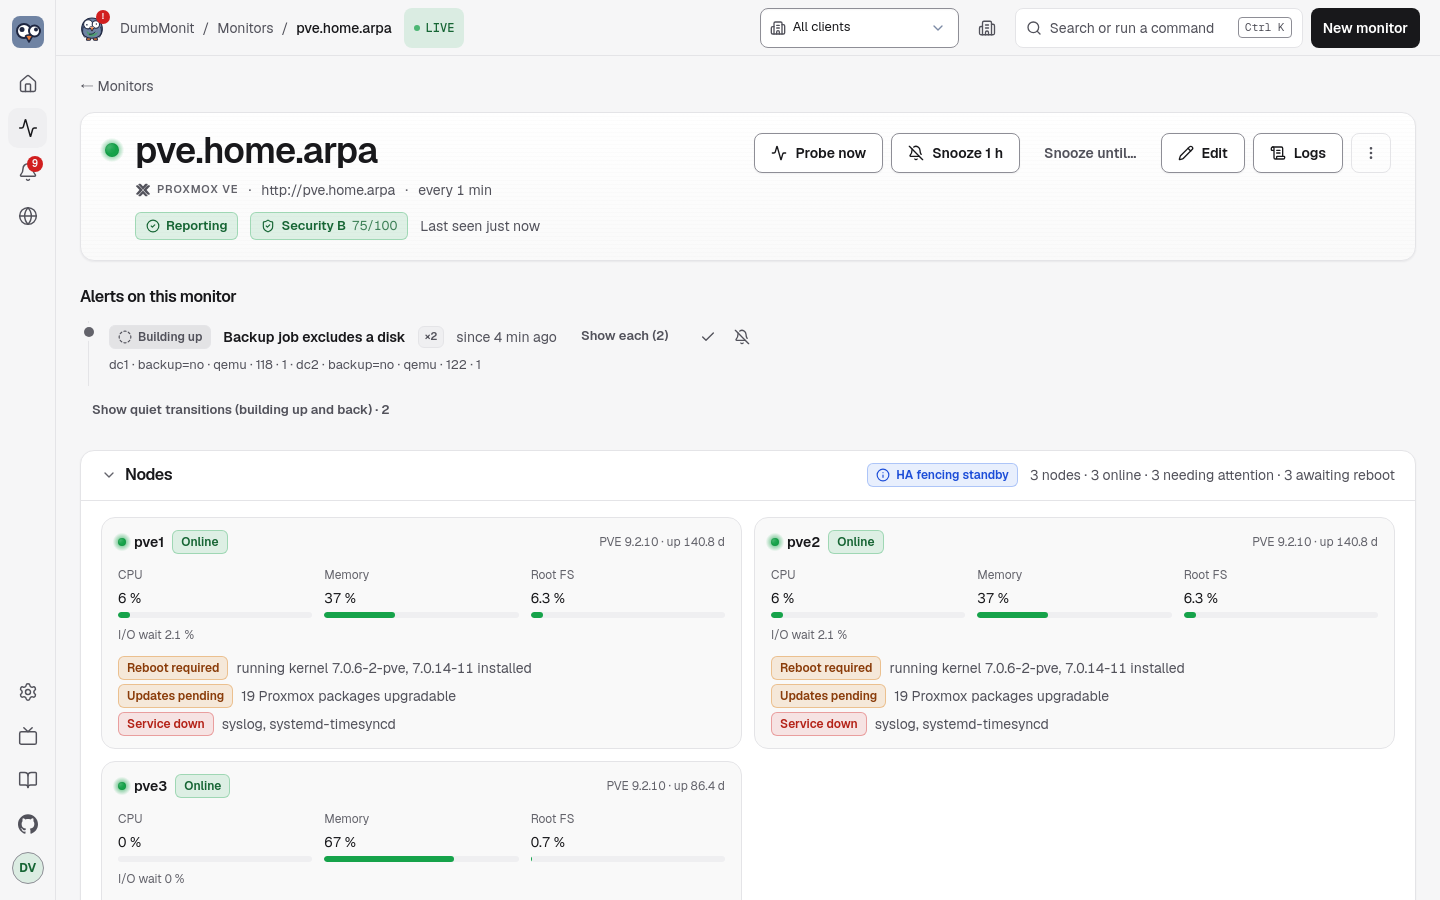
Sous les nœuds, le panneau Invités : une ligne par machine virtuelle et conteneur, groupée par nœud, qui répond aux questions qu’un administrateur pose en premier — est-ce que ça tourne, est-ce que c’est occupé, est-ce que le disque est plein, quand a eu lieu la dernière sauvegarde. Chaque ligne montre :
| Colonne | Source | Notes |
|---|---|---|
| Statut | mot + plaque : en cours, arrêté, en pause, suspendu, template | Un template est listé mais ne compte jamais comme « arrêté ». |
| Nom, VMID, nœud | l’inventaire | |
| CPU | guest_cpu_percent, des cœurs alloués à l’invité | Une barre plus le nombre de cœurs. |
| Mémoire | guest_memory_used_bytes / guest_memory_total_bytes | La taille du ballon quand la VM en a un. Une seconde ligne, +N sur l’hôte, apparaît quand guest_memory_host_bytes est sensiblement au-dessus de ce que l’invité voit : un processus QEMU coûte plus à l’hyperviseur que la mémoire qu’il cède à l’invité, et ce surplus est le coût de l’émulation. Sous 64 Mio ou 5 %, la ligne reste cachée. |
| Disque | guest_disk_used_bytes / guest_disk_total_bytes | Conteneurs : usage réel. VMs : taille toujours ; usage seulement quand l’agent invité QEMU répond (voir ci-dessous), sinon « taille seulement ». |
| Réseau | rate(guest_network_in/out_bytes) sur les dernières sondes | |
| Uptime | guest_uptime_seconds | |
| Dernière sauvegarde | backup_last_age_seconds | Vide quand aucune sauvegarde n’est connue. |
| HA | ha_resource_state_info | Seulement pour les invités sous haute disponibilité. |
| Verrou | guest_locked | Un badge, seulement tant qu’un verrou est tenu (backup, migrate, snapshot…). |
La liste se trie par n’importe quelle colonne, se filtre par nœud,
statut ou pool, et chaque groupe de nœud se replie. Cliquer sur une
ligne ouvre son CPU et sa mémoire sur la plage de temps de la page,
avec le système d’exploitation et les adresses IP vues depuis
l’intérieur de l’invité. La donnée vient de
GET /api/targets/{id}/proxmox/guests, qui lit la dernière sonde dans
le magasin de métriques — rien n’est demandé à l’hyperviseur.
Un verrou est normal pendant les quelques minutes qu’une sauvegarde, une
migration ou un snapshot prennent. Laissé par une tâche interrompue, il
bloque toute opération sur cet invité — y compris la sauvegarde de la
nuit suivante — jusqu’à ce que qm unlock (ou pct unlock) l’efface,
c’est pourquoi « Invité verrouillé » se déclenche après six heures.
L’inventaire vient de /cluster/resources, le propre cache du cluster,
les invités d’un nœud qui a arrêté de répondre sont donc toujours
listés — avec le statut unknown et leurs tailles, sans mesures en
direct — plutôt que de disparaître du panneau au moment où vous voulez
regarder. Ça coûte aussi deux appels d’API de moins par nœud que de
parcourir /nodes/{node}/qemu et /nodes/{node}/lxc, ce sur quoi
l’option cluster_resources se replie quand elle est désactivée.
Usage disque dans une VM : l’agent invité QEMU
Section intitulée « Usage disque dans une VM : l’agent invité QEMU »Proxmox voit le disque d’une VM comme un volume opaque : disk est
toujours 0 pour une VM, seule sa taille est connue. Pour lire l’usage
depuis l’intérieur, le collecteur demande à l’agent invité QEMU
(agent/get-fsinfo) pour chaque VM en cours dont la configuration
active l’agent (Options → QEMU Guest Agent). Deux conditions :
qemu-guest-agentinstallé et en cours à l’intérieur de la VM (Debian et Ubuntu :apt install qemu-guest-agent; Windows : l’ISO des pilotes VirtIO) ;- le jeton détient
VM.GuestAgent.Auditsur la VM —VM.Monitoravant Proxmox VE 9 (le rôleDumbMonitci-dessous l’accorde sur/).
Le système de fichiers racine (/, ou C:\ sous Windows ; sinon le
plus grand) donne guest_disk_used_bytes et guest_disk_used_percent,
la même série qu’un conteneur a, la règle « VM ou conteneur disque
presque plein » couvre donc les deux. Chaque vrai système de fichiers
obtient aussi guest_fs_total/used_bytes et guest_fs_used_percent
avec un label mountpoint ; les pseudo-systèmes de fichiers (tmpfs,
squashfs, montages snap) et les médias sans capacité sont ignorés.
guest_agent_enabled dit si la configuration de la VM active l’agent,
guest_agent_running s’il a répondu. Sans l’agent ou le droit, la VM
garde sa taille et n’a simplement pas d’usage — jamais un « 0 % »
trompeur.
Le système d’exploitation et les adresses d’un invité
Section intitulée « Le système d’exploitation et les adresses d’un invité »Proxmox ne connaît que le type d’OS écrit dans la configuration d’un
invité (l26, win11), pas ce qui tourne réellement. Avec l’option
guest_os activée, le collecteur demande à chaque invité en cours ce
qu’il est : agent/get-osinfo et agent/network-get-interfaces pour
une VM, /nodes/{node}/lxc/{vmid}/interfaces pour un conteneur, qui
n’a besoin de rien d’installé dedans. Ça donne guest_os_info (Debian GNU/Linux 12 (bookworm), son id, sa version, le noyau) et jusqu’à
quatre guest_ip_info — les adresses loopback et IPv6 link-local sont
ignorées, de même que les ponts Docker, les paires veth et les autres réseaux
de conteneurs (docker0, br-…, veth…, cni…), et une machine avec des
dizaines d’interfaces virtuelles ne remplit pas la base de séries. Quand un
invité ne dit rien de ses adresses (VM sans agent, ou sans le droit de
l’interroger), le collecteur se rabat sur les adresses statiques de sa
configuration (ipconfigN cloud-init de /nodes/{node}/qemu/{vmid}/config,
netN … ip= de /nodes/{node}/lxc/{vmid}/config ; dhcp n’en donne aucune),
ce que VM.Audit — compris dans PVEAuditor — permet déjà.
La carte se sert de ces adresses : une surveillance dont l’adresse est l’une de celles d’un invité (un contrôle HTTP, un port TCP, une base de données…) se dessine sous cette VM ou ce conteneur avec un lien « Tourne sur » au lieu de flotter seule, et un agent, un ping ou une surveillance SNMP à l’adresse d’un invité représente l’invité lui-même. Les noms d’hôte ne sont pas résolus : seules les surveillances visées par adresse IP sont reliées ainsi (un invité dont le nom correspond à une surveillance ou au nom d’hôte d’un agent est relié par son nom, comme avant).
Les deux sont demandés au plus une fois par heure par invité et republiés depuis la mémoire entre deux : un système d’exploitation ne change pas entre deux sondes, et une adresse presque jamais. Sur un cluster de cinquante machines en cours, c’est la différence entre deux appels supplémentaires par sonde et deux par heure.
Ces deux appels d’agent ont besoin de VM.GuestAgent.Audit. Proxmox VE
7 ne l’avait pas et utilisait VM.Monitor ; Proxmox VE 9 a retiré
VM.Monitor et ne garde que les privilèges d’agent invité. Sans celui
que votre version connaît, les deux séries sont simplement absentes ;
rien d’autre ne change.
Le panneau Ceph
Section intitulée « Le panneau Ceph »Une section Ceph apparaît sur la page de la surveillance seulement quand le cluster a réellement Ceph : santé et les mots derrière, capacité totale et utilisée, combien d’OSD sont up et in, un tableau d’OSD (hôte, classe de périphérique, usage, latence apply et commit) et un tableau de pools (usage, size et min size, groupes de placement par rapport au nombre que l’autoscaler choisirait), les systèmes de fichiers CephFS, les drapeaux OSD laissés réglés et les contrôles de santé actuellement mis en sourdine.
Ces deux derniers sont ceux qu’un tableau de bord cache généralement.
noout réglé pour une maintenance et jamais effacé signifie que Ceph ne
rééquilibrera plus un OSD mort, et un contrôle mis en sourdine
n’apparaît plus dans HEALTH_OK — dans les deux cas le cluster a l’air
sain tandis que sa redondance disparaît discrètement.
GET /api/targets/{id}/proxmox/ceph répond available: false quand le
cluster n’a pas Ceph, c’est comme ça que l’UI sait ne pas dessiner la
section du tout. Le détail coûte trois appels sur un seul nœud plus
deux à l’échelle du cluster, quelle que soit la taille du cluster, et a
besoin de l’option ceph_detail en plus de ceph.
Ce qu’il surveille
Section intitulée « Ce qu’il surveille »Toutes les métriques sont préfixées dumbmonit_proxmox_.
| Famille | Métriques | Labels |
|---|---|---|
| Cluster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online ; version_info (+ version, release, repoid) | cluster, node |
| Inventaire cluster | cluster_guests_total, cluster_guests_running, cluster_templates_total (templates comptés à part, jamais comme « arrêté ») ; pool_guests, un par pool de ressources | pool |
| Nœuds | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (temps passé à attendre les disques — un nœud à 10 % de CPU et 30 % d’iowait n’a plus de marge), node_ksm_shared_bytes (mémoire récupérée par déduplication de pages), node_uptime_seconds, node_version_info | node |
| Services de nœud | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down ; node_pve_version_info (+ version, release) pour le nœud qui a répondu | node, service |
| Réseau de nœud | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline ; total node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth…) |
| LVM, pools thin et montages | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (label vg) ; node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (labels vg, pool) ; node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Invités (VMs et conteneurs) | guest_status_info (+ status : running, stopped, paused, suspended, template), guest_running (pas pour les templates), guest_cpu_percent (des cœurs alloués), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9 : la mémoire que la VM prend sur l’hôte, coût d’émulation inclus), guest_memory_percent (du propre point de vue de l’invité ; sur Proxmox VE 9 elle vient du pilote de ballon, et une VM sans en a des octets mais pas de pourcentage plutôt qu’un chiffre au-dessus de 100 %), guest_disk_total_bytes, guest_disk_used_bytes et guest_disk_used_percent (conteneurs ; VMs seulement via l’agent invité), guest_disk_read/write_bytes, guest_network_in/out_bytes (compteurs), guest_uptime_seconds ; guest_pool_info (+ pool), guest_locked (+ lock ; la série n’existe que tant que le verrou est tenu, sa durée se lit donc directement sur le graphique) | node, vmid, name, type (qemu ou lxc) |
| Détail VM (VMs en cours) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (mémoire libre vue de l’intérieur, pilote de ballon), guest_running_qemu_info (+ version : le QEMU avec lequel la VM a été démarrée — après une mise à niveau d’hyperviseur il reste en retard jusqu’à ce que la VM soit arrêtée et redémarrée, ce qu’une migration à chaud ne fait pas) ; par système de fichiers guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type ; systèmes de fichiers : + mountpoint, fstype |
| Système et adresses invité | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip ; quatre adresses routables par invité au plus). Rafraîchi une fois par heure | node, vmid, name, type |
| Cartes réseau invité | guest_netdev_in_bytes, guest_netdev_out_bytes (compteurs), une paire par interface virtuelle là où guest_network_in/out_bytes ne donne que le total de l’invité | node, vmid, dev (tap100i0, veth200i0) |
| Stockages | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (la capacité n’est publiée que quand Proxmox en rapporte une : un stockage inactif, ou un datastore PBS dont PVE ne lit pas la taille, n’en a aucune plutôt que zéro octet) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs…), shared |
| Sauvegardes (par invité) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count ; totaux backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Sauvegardes (exécutions vzdump, par nœud) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Jobs de sauvegarde (planifiés) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (les deux derniers seulement quand une tâche vzdump porte l’id du job, PVE 7.2+) ; totaux backup_jobs_total, backup_guests_not_covered ; backup_covered par invité (0 pour un invité qu’aucun job ne couvre) | job, storage, schedule ; backup_covered : vmid, name, node, type |
| Couverture de job de sauvegarde | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded ; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), publié seulement pour une exclusion inattendue | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state : Proxmox VE 9 rapporte si le watchdog est armed ou en standby — en standby rien ne sera isolé), ha_master_active, ha_lrm_active (node), ha_resources_total ; par ressource ha_resource_started, ha_resource_error (1 en état error, fence ou recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| Gestionnaire HA | ha_node_online, ha_node_status_info (+ status : online, fence, gone, maintenance), ha_master_info (le nœud détenant le maître CRM), ha_manager_age_seconds ; par nœud ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1 quand le LRM n’a pas écrit depuis plus de deux minutes) | node |
| Snapshots | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (âges seulement quand count > 0) ; guest_snapshot_guests_skipped quand max_snapshot_guests est dépassé | vmid, name, node, type |
| Réplication | replication_job_enabled, replication_job_error (message d’erreur ou fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds ; replication_jobs_total | job, vmid, node (source), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 inconnu), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| Ceph OSDs | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight ; totaux ceph_osds_down, ceph_osds_out | osd, host, device_class |
| Pools Ceph et CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (ce que l’autoscaler choisirait), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total ; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool ; CephFS : name |
| Drapeaux et mutes Ceph | ceph_flag (1 tant que le drapeau est réglé), ceph_flags_set ; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag ; mutes : code |
| Disques physiques | node_disk_size_bytes, node_disk_smart_failed (1 quand la santé SMART est FAILED ; absent quand le disque rapporte UNKNOWN), node_disk_health_info (+ health, used : LVM, ZFS, partitions…), node_disk_wearout_percent (SSD et NVMe : 0 neuf, 100 fin de vie nominale), node_disk_temperature_celsius (depuis disks/smart : attribut ATA 194/190, ou la ligne de température d’un rapport texte — Temperature: pour NVMe, Current Drive Temperature: pour SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| Pools ZFS | node_zfs_pool_degraded (1 sauf ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Mises à jour | node_updates_pending, node_updates_security_pending (paquets dont l’origine, le label de dépôt, la suite, la section ou l’URL de changelog nomme une archive de sécurité, comme le bookworm-security de Debian). Sans Sys.Modify ces deux n’existent pas ; node_pve_packages_upgradable compte alors quand même les paquets Proxmox dont la version candidate diffère de l’installée, et node_reboot_required (+ running, installed) dit qu’un noyau plus récent est installé mais pas encore démarré — les deux lus depuis apt/versions, qui n’a besoin que de Sys.Audit | node |
| Changements de paquet | node_packages_changed : 0 normalement ; pendant une heure après qu’une sonde voit la version installée d’un paquet Proxmox changer (apt/versions), le nombre de paquets qui ont changé, avec un label changes comme pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Abonnement et dépôts | node_subscription_active, node_subscription_info (+ status : active, notfound, expired…, level, next_due) ; node_repository_errors (fichiers sources illisibles), node_repository_warnings (propres avertissements de Proxmox : dépôt enterprise sans abonnement, dépôt de test), node_repository_enabled (+ repo : enterprise, no-subscription, test, ceph-*) | node |
| Certificats | node_certificate_expiry_days (négatif une fois expiré) | node, filename, subject |
| Flux RRD (désactivé par défaut) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — chaque mesure que les propres serveurs de métriques de Proxmox reçoivent, sous son propre nom (voir metrics_export ci-dessous) | node ; invités : vmid, type ; stockages : node, storage |
| Options sautées | feature_skipped_info : 1 tant qu’un appel facultatif est refusé (403) faute de droit, absente sinon. La page du moniteur l’affiche en note discrète qui nomme le droit ; ce n’est ni une erreur de sonde ni une alerte | feature, privilege |
| Collection | up, scrape_errors, scrape_duration_seconds |
L’âge de sauvegarde par machine répond à la panne la plus coûteuse d’un
homelab : la sauvegarde qui n’a pas tourné depuis des semaines,
découverte le jour de la restauration. Il est calculé depuis le journal
de tâches vzdump (sur backup_lookback_days) et, si
scan_backup_storage est activé, depuis les archives trouvées sur les
stockages de sauvegarde.
Les jobs planifiés viennent de Datacenter → Backup : backup_covered
est à 0 pour chaque invité que Proxmox lui-même liste comme non couvert
par aucun job, une machine créée hier se montre donc avant sa première
sauvegarde manquée plutôt qu’après.
Un job qui couvre un invité n’écrit pas forcément tous ses disques. Un
volume marqué backup=0 est sauté chaque nuit, le job rapporte quand
même un succès, et personne ne le découvre avant une restauration.
backup_job_guest_excluded_volumes nomme le job, l’invité et la propre
raison de Proxmox pour l’exclusion — mais seulement quand l’exclusion
est une surprise : un lecteur CD-ROM, une image cloudinit ou une entrée
qui n’est pas du tout un volume est exclue par conception, comptée dans
backup_job_volumes_excluded et jamais rapportée par invité. Sans cette
distinction, chaque machine avec un lecteur virtuel déclencherait une
alerte.
Les démons d’un nœud valent d’être surveillés pour une raison :
pvestatd arrêté ne casse rien visiblement — l’interface web continue
d’afficher les chiffres depuis le moment où il est mort, et tout a l’air
normal. node_core_services_down ne compte que pve-cluster,
pvedaemon, pveproxy, pvestatd, pve-firewall, corosync et
watchdog-mux, et seulement ceux que le nœud lui-même déclare activés,
donc un nœud autonome sans corosync ni HA ne compte rien de manquant.
Une interface compte comme hors ligne quand elle est réglée pour démarrer au boot et n’est pas active (ou n’existe plus du tout). Une amenée à la demande, sans autostart, n’est jamais rapportée : son absence est normale. Un bridge qui ne revient pas après un redémarrage coupe chaque invité attaché à lui tandis que chacun de ces invités tourne parfaitement, et rien d’autre ne le dit.
Un pool thin LVM qui se remplit met en lecture seule chaque invité stocké sur lui d’un coup, et supprimer des fichiers à l’intérieur des invités ne rend pas l’espace. Ses métadonnées vivent sur leur propre volume, bien plus petit, et saturent souvent d’abord, avec exactement la même conséquence — c’est pourquoi les deux niveaux de remplissage sont des séries séparées et des règles séparées.
Les changements de paquet sont détectés par le collecteur lui-même : il se souvient des versions installées de la sonde précédente (par surveillance et nœud, en mémoire — un redémarrage de serveur réapprend sans rapporter). Seul un paquet présent dans les deux sondes avec une version différente compte ; un paquet nouvellement installé ou retiré ne compte pas.
Une panne partielle (un nœud en panne, un stockage lent) reste une sonde
réussie : ce qui a pu être lu est écrit et l’échec est compté dans
scrape_errors. Les fonctionnalités simplement absentes restent
silencieuses : pas de Ceph, pas de job de réplication, pas de pool ZFS,
pas d’agent invité, ou pas de droit de lister les mises à jour ne
produisent aucune série ni erreur. Pareil pour tout ce qui précède : un
privilège manquant (403), un point de terminaison qu’un Proxmox plus
ancien n’a pas (404 ou 501), une fonctionnalité qui n’est pas installée
(Ceph répond 500) ne produisent aucune erreur ni métrique du tout —
jamais un zéro qui prétend être une mesure.
Les températures de carte ne sont pas disponibles : l’API de Proxmox VE n’expose pas de capteurs, seulement la propre température SMART des disques. Installez l’agent DumbMonit sur le nœud si vous en avez besoin de plus.
Règles intégrées qui s’appliquent : Surveillance inaccessible, CPU élevé, Disque presque plein, Système de fichiers presque plein (prévision), Sauvegarde trop ancienne, CPU inhabituel, VM ou conteneur arrêté, VM ou conteneur CPU élevé, VM ou conteneur mémoire élevée, VM ou conteneur disque presque plein, Ressource HA en erreur, Cluster a perdu le quorum, Nœud hors ligne, Stockage presque plein, Job de sauvegarde échoué, Vieux snapshot, Réplication échouée, Erreur de santé Ceph, Avertissement de santé Ceph, Mises à jour en attente, Mises à jour de sécurité en attente, Paquets Proxmox changés, Disque Proxmox qui s’use, Échec SMART de disque Proxmox, Pool ZFS Proxmox dégradé, Certificat de nœud arrivant à expiration, Pool thin presque plein, Métadonnées de pool thin presque pleines, Service Proxmox arrêté, Interface réseau de nœud en panne, OSD Ceph en panne, OSD Ceph presque plein, Pool Ceph presque plein, Drapeau noout Ceph laissé actif, Gestionnaire HA ne rapporte pas, Job de sauvegarde exclut un disque, Invité verrouillé.
Le flux RRD complet
Section intitulée « Le flux RRD complet »/cluster/metrics/export est le point de terminaison que les propres
serveurs de métriques de Proxmox (InfluxDB, Graphite) consomment : tout
ce que pvestatd mesure, pour tout le cluster, en un appel. Deux
choses en font la peine.
- Il porte des mesures que rien d’autre n’expose — en particulier l’information de pression par nœud (PSI) : combien de temps les tâches passent à attendre le CPU, le disque ou la mémoire. C’est le chiffre qui explique « tout est lent » quand CPU et mémoire ont tous les deux l’air bien.
- Il est lu avec
history=1depuis le dernier point déjà vu, chaque point entre deux sondes est donc ingéré à son propre horodatage. Une surveillance sondée toutes les cinq minutes obtient ses cinq points d’une minute plutôt qu’une seule valeur actuelle.
C’est désactivé par défaut, et c’est un compromis délibéré. Ces
séries répètent en partie celles que le reste de la collection produit
déjà sous de meilleurs noms, activer metrics_export ajoute donc un
grand nombre de séries à stocker et à parcourir pour un détail que la
plupart des installations ne regardent jamais. Les noms sont publiés
exactement comme Proxmox les envoie (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin…) plutôt que traduits : Proxmox en ajoute à chaque
release, et une table de traduction écrite ici serait fausse à la
prochaine. Ça a besoin de Sys.Audit sur / — que le rôle DumbMonit
a déjà quand il a été accordé sur / comme ci-dessous.
Ce qu’il faut préparer dans Proxmox
Section intitulée « Ce qu’il faut préparer dans Proxmox »-
Ouvrez Datacenter → Permissions → Users → Add, saisissez le nom d’utilisateur dumbmonit, choisissez le realm Proxmox VE authentication server, puis cliquez sur Add.
dumbmonit@pve -
Ouvrez Datacenter → Permissions → Add → User Permission : chemin /, utilisateur dumbmonit@pve, rôle PVEAuditor, puis cliquez sur Add.
-
Ouvrez Datacenter → Permissions → API Tokens → Add : utilisateur dumbmonit@pve, Token ID monitor, décochez Privilege Separation, puis cliquez sur Add.
dumbmonit@pve!monitor -
Copiez le Token ID et le Secret dans les champs Token ID et Secret de DumbMonit. Le secret n’est affiché qu’une seule fois.
-
Facultatif, pour le compte des mises à jour en attente : Datacenter → Permissions → Roles → Create, un rôle avec le seul privilège Sys.Modify, puis ajoutez-le en User Permission sur le chemin /nodes.
-
Dans DumbMonit, saisissez l’adresse d’un nœud quelconque (port 8006 par défaut).
Droits requis
Section intitulée « Droits requis »- PVEAuditor sur / : Lecture seule : nœuds, stockage, VM, conteneurs, sauvegardes, agent invité
- Sys.Modify sur /nodes (facultatif) : Seulement pour lister les mises à jour en attente
- VM.Monitor sur / (facultatif, Proxmox VE 8) : Seulement pour les options de l’agent invité QEMU
Documentation de l’éditeur : Proxmox VE user management
Pourquoi ces droits
Section intitulée « Pourquoi ces droits »Ne réutilisez pas le compte avec lequel vous vous connectez : un jeton divulgué contrôlerait tout le cluster. Le rôle ci-dessous ne sait que lire.
PVEAuditorest un rôle intégré qui regroupe les privilèges de lecture de chaque catégorie. DumbMonit utiliseSys.Audit(nœuds, cluster, HA, disques et SMART, ZFS, certificats, versions de paquets, abonnement),Datastore.Audit(stockages et archives de sauvegarde),VM.Audit(VM, conteneurs, snapshots) et, sur Proxmox VE 9,VM.GuestAgent.Audit(ce que l’agent invité QEMU lit dans une VM : occupation des disques, système d’exploitation, adresses IP). Le rôle porte aussiPool.Audit,SDN.AuditetMapping.Audit, inutilisés mais sans danger. Aucun ne peut rien modifier.- La séparation des privilèges est désactivée : le jeton hérite simplement des droits de l’utilisateur, une seule permission sur l’utilisateur suffit.
- Proxmox protège la liste des mises à jour et correctifs de sécurité en
attente par
Sys.Modify. Accordez-le sur/nodesuniquement, par un rôle qui ne contient rien d’autre ; sans lui, le collecteur ignore la liste sans bruit. - Sur Proxmox VE 8,
VM.GuestAgent.Auditn’existe pas encore etPVEAuditorn’a pasVM.Monitor, qui couvre les appels à l’agent invité. Sans lui, l’occupation des disques, le système et les adresses lus dans les VM manquent. Créez un rôle contenantVM.Monitoret accordez-le sur/vms. Proxmox VE 9 a retiréVM.Monitorà son tour : ne créez pas ce rôle là-bas. - Le certificat de Proxmox est auto-signé par défaut : si la connexion est refusée pour cette raison, cochez « Accepter un certificat non vérifiable » dans les options.
Vous préférez un shell ? La même configuration depuis un nœud (interface web : sélectionnez le nœud, puis Shell ; ou SSH) :
pveum user add dumbmonit@pve --comment "DumbMonit monitoring"pveum aclmod / -user dumbmonit@pve -role PVEAuditorpveum user token add dumbmonit@pve monitor --privsep 0pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdatespveum role add DumbMonitGuestAgent --privs VM.Monitorpveum aclmod /vms -user dumbmonit@pve -role DumbMonitGuestAgentLes deux dernières lignes ne concernent que Proxmox VE 8.
Identifiants
Section intitulée « Identifiants »| Identifiant | Champs |
|---|---|
| Jeton d’API (recommandé) | Token ID : utilisateur, domaine et nom de jeton comme Proxmox les montre, dumbmonit@pve!monitor. Secret : l’UUID montré une fois à la création du jeton. Pas d’expiration, aucune session ouverte sur l’hyperviseur. |
| Nom d’utilisateur / mot de passe | user@realm et le mot de passe. Un ticket est obtenu, mis en cache et renouvelé dix minutes avant son expiration de deux heures. |
L’API accepte le jeton en deux morceaux (token_id + secret) ou,
comme le faisaient les anciennes versions, comme une seule chaîne
token = user@realm!name=secret ; les deux sont stockés de la même
façon. Un jeton entier collé dans Token ID est découpé par le
formulaire.
Le rôle DumbMonit ci-dessus porte ce que PVEAuditor accorde pour les
chemins que le collecteur lit, plus le privilège d’agent invité : le
collecteur ne fait toujours que des GET. Par point de terminaison :
Sys.Audit pour /version, /cluster/*, /nodes/{node}/status,
services, version, network, netstat, tasks, replication,
certificates/info, disks/list, disks/smart, disks/zfs,
apt/versions, apt/repositories et subscription ; Datastore.Audit
pour storage et storage/{id}/content ; VM.Audit pour qemu,
lxc, snapshot, status/current, la config d’un invité et les interfaces d’un conteneur ;
VM.GuestAgent.Audit — ou VM.Monitor avant Proxmox VE 9 — pour
agent/get-fsinfo.
Deux chemins demandent un peu plus que le reste, et les deux sont
couverts par le rôle tel qu’accordé à l’étape 3 — sur /, pas sur
/nodes :
Sys.Auditsur/pour l’inventaire LVM (disks/lvm,disks/lvmthin,disks/directory) et pour/cluster/metrics/export, le flux RRD optionnel. Accordé seulement sur/nodes, les séries de pool thin et les séries*_rrd_*sont silencieusement absentes.VM.GuestAgent.Auditpour les deux appels d’agent invité qui lisent le système d’exploitation et les adresses d’une VM (agent/get-osinfo,agent/network-get-interfaces). Proxmox VE 7 n’avait pas ce privilège et utilisaitVM.Monitor; Proxmox VE 9 a retiréVM.Monitor. Sans celui que votre version connaît,guest_os_infoetguest_ip_infone sont simplement pas publiés pour les VMs ; les conteneurs, qui n’ont besoin d’aucun agent, gardent leurs adresses.
La seule chose que le rôle ne couvre pas du tout est la liste des mises
à jour en attente (apt/update), que Proxmox protège avec
Sys.Modify sur /nodes — optionnel, comme l’étape 6 l’explique ;
sans ça le collecteur ignore node_updates_pending et
node_updates_security_pending en silence.
(Utilisez -token 'dumbmonit@pve!monitor' au lieu de -user dans les
commandes aclmod pour un jeton créé avec « Privilege Separation »
cochée.)
Adresse : 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] ou une URL
complète https://pve.example.net. Le schéma https et le port 8006
sont ajoutés s’ils manquent.
| Clé | Libellé | Défaut | Aide |
|---|---|---|---|
port | Port de l’API | 8006 | Utilisé si l’adresse ne donne pas de port. |
insecure_tls | Accepter un certificat non vérifiable | false | Proxmox livre un certificat autosigné par défaut : activez ceci si la connexion est refusée pour cette raison. |
request_timeout_seconds | Délai par requête (secondes) | 10 | Temps accordé à chaque appel d’API, de 1 à 120. |
backup_lookback_days | Historique de sauvegarde (jours) | 31 | Les tâches de sauvegarde plus anciennes ne sont pas examinées, de 1 à 3650. |
scan_backup_storage | Inventorier les archives de sauvegarde | true | Scanne les stockages de sauvegarde pour dater la dernière sauvegarde de chaque machine. Désactivez si le stockage répond lentement. |
nodes | Nœuds surveillés | (vide) | Noms des nœuds à surveiller, séparés par des virgules. Vide : chaque nœud du cluster. |
cluster_resources | Lire l’inventaire du cluster | true | Un appel à /cluster/resources liste chaque nœud, invité, stockage et pool. Gardez-le activé : c’est la seule source qui voit encore les invités d’un nœud qui a arrêté de répondre, et ça économise deux appels par nœud. Désactivé, le collecteur parcourt /nodes/{node}/qemu et /nodes/{node}/lxc à la place, et perd les pools et verrous. |
services | Surveiller les services de nœud | true | /nodes/{node}/services et version : l’état des démons Proxmox de chaque nœud et la version installée sur lui. Un pvestatd arrêté laisse tout le cluster afficher des chiffres gelés. |
network | Surveiller le réseau de nœud | true | /nodes/{node}/network et netstat : bridges, bonds et VLAN avec leur état de lien, plus les compteurs de trafic de chaque carte réseau d’invité. |
lvm | Surveiller LVM et les pools thin | true | disks/lvm, disks/lvmthin et disks/directory : groupes de volumes, pools thin (remplissage des données et des métadonnées) et montages de répertoire gérés par PVE. A besoin de Sys.Audit sur / ; silencieux sinon. |
ha | Haute disponibilité | true | Lit /cluster/ha/status/current et manager_status : quorum, maître CRM, la propre vue du gestionnaire de chaque nœud, chaque LRM avec l’âge de son dernier rapport, et chaque ressource HA. |
backup_jobs | Jobs de sauvegarde planifiés | true | Lit les jobs depuis Datacenter → Backup et les invités qu’aucun job ne couvre. |
scan_snapshots | Inventorier les snapshots | true | Un appel par invité (quatre en vol par nœud). Désactivez sur de très grands clusters. |
max_snapshot_guests | Limite d’inventaire de snapshot | 200 | Les invités au-delà de ce nombre sont sautés à chaque sonde et comptés dans guest_snapshot_guests_skipped, de 1 à 10000. |
replication | Jobs de réplication | true | Statut de réplication de stockage par nœud. Silencieux quand le nœud n’a pas de job. |
ceph | Santé Ceph | true | Lit /cluster/ceph/status. Silencieux quand Ceph n’est pas installé. |
ceph_detail | Surveiller Ceph en détail | true | État, usage et latence par OSD, usage par pool, CephFS, drapeaux OSD et contrôles de santé en sourdine. Trois appels sur un nœud plus deux à l’échelle du cluster, quelle que soit la taille du cluster. A besoin de ceph activé ; silencieux sans Ceph. |
backup_volumes | Vérifier ce que les jobs de sauvegarde incluent | true | Pour chaque job planifié, quels invités il couvre et lesquels de leurs disques il écrit réellement. Attrape un job qui réussit chaque nuit tout en sautant un disque de données. Un appel par job. |
guest_os | Lire l’OS et les adresses invité | true | Système d’exploitation et adresses IP vues de l’intérieur de chaque invité en cours (agent invité QEMU pour les VMs, le namespace du conteneur pour les conteneurs). Rafraîchi une fois par heure par invité, pas à chaque sonde. A besoin de VM.GuestAgent.Audit sur Proxmox VE 8. |
metrics_export | Ingérer le flux complet de métriques RRD | false | Lit /cluster/metrics/export, le flux que les propres serveurs de métriques de Proxmox consomment, incluant la pression par nœud (PSI), et chaque point depuis la dernière sonde plutôt que juste l’actuel. Désactivé par défaut : les séries *_rrd_* qu’il ajoute répètent en partie celles déjà collectées. A besoin de Sys.Audit sur /. |
updates | Mises à jour en attente | true | Compte les paquets que apt/update liste. A besoin de Sys.Modify sur /nodes (voir ci-dessus) ; silencieux sinon. |
certificates | Expiration des certificats | true | Jours restants sur chaque certificat de nœud (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | Demander à l’agent invité QEMU | true | Pour chaque VM en cours : status/current (ballon, drapeau d’agent) et, quand l’agent est activé, agent/get-fsinfo (a besoin de VM.GuestAgent.Audit). Quatre appels en vol par nœud. Silencieux quand l’agent est absent. |
disks | Surveiller les disques physiques | true | disks/list plus un appel disks/smart par disque : santé, usure, température. |
zfs | Surveiller les pools ZFS | true | disks/zfs : santé, capacité, fragmentation. Silencieux sans ZFS. |
packages | Détecter les changements de paquet | true | apt/versions comparé à la sonde précédente ; un changement est rapporté pendant une heure dans node_packages_changed. |
subscription | Surveiller l’abonnement et les dépôts | true | subscription et apt/repositories : statut, avertissements, dépôts standards activés. |
Erreurs courantes
Section intitulée « Erreurs courantes »| Symptôme | Cause probable |
|---|---|
| Erreur de certificat montrée sur la surveillance | Certificat autosigné. Soit installez un certificat de confiance (ACME est intégré à Proxmox) soit activez insecure_tls. L’option n’est jamais activée implicitement. |
| Erreur d’authentification | Secret collé dans Token ID (ou l’inverse), « Privilege Separation » laissée cochée (le jeton n’a alors aucun droit), ou le rôle DumbMonit non appliqué sur /. |
| Âge de sauvegarde manquant pour un invité | Aucune tâche vzdump dans la fenêtre d’historique et aucune archive trouvée sur les stockages ; ou scan_backup_storage désactivé. |
| Sondes lentes | Un stockage de sauvegarde qui prend du temps à lister, ou beaucoup d’invités à inventorier pour les snapshots. Désactivez scan_backup_storage ou scan_snapshots, baissez max_snapshot_guests, ou augmentez request_timeout_seconds. |
node_updates_pending manquant | L’utilisateur ou le jeton manque Sys.Modify sur /nodes. Accordez le rôle DumbMonitUpdates de l’étape 6, ou ignorez : node_pve_packages_upgradable et node_reboot_required couvrent les paquets Proxmox sans ça. |
| Aucun pourcentage de mémoire pour une VM | Proxmox VE 9 rapporte, dans l’inventaire du cluster, la mémoire que la VM prend sur l’hôte — coût inclus, donc régulièrement au-dessus de son allocation. Un pourcentage calculé depuis ça resterait au-dessus de 100 % pour toujours. Le chiffre honnête vient du pilote de ballon à l’intérieur de l’invité ; une VM avec le ballooning désactivé montre donc des octets et pas de pourcentage. guest_memory_host_bytes est le chiffre côté hôte. |
| Aucune capacité pour le stockage de sauvegarde | Un datastore Proxmox Backup Server monté sur PVE ne rapporte aucune taille : PVE ne la lit pas. La propre page de surveillance du datastore l’a. |
| Usage disque vide (« taille seulement ») pour une VM | La VM n’a pas d’agent invité QEMU (pas activé dans ses options, ou qemu-guest-agent pas installé dedans), ou le jeton manque VM.GuestAgent.Audit. guest_agent_enabled et guest_agent_running disent lequel. Les conteneurs n’en ont jamais besoin. |
Aucune série node_disk_* | Le jeton manque Sys.Audit sur / (le rôle DumbMonit l’accorde), ou le nœud tourne derrière un contrôleur RAID qui cache SMART : disks/list rapporte alors UNKNOWN et aucun node_disk_smart_failed n’est publié. |
node_packages_changed se déclenche après un redémarrage de serveur | Non : la première sonde après un redémarrage n’apprend que les versions. Un changement n’est rapporté qu’entre deux sondes consécutives du même processus serveur. |
backup_job_last_ok{job=…} manquant tandis que backup_job_last_ok{node=…} existe | Les tâches vzdump ne portent pas l’id du job (Proxmox VE plus ancien que 7.2, ou jobs lancés à la main). Le statut d’exécution par nœud est quand même là. |
| Aucune métrique Ceph ou de réplication | Rien à rapporter : Ceph n’est pas installé, ou aucun job de réplication n’est configuré. Pas une erreur. |
| Aucun pool thin ou groupe de volumes sur une carte de nœud | L’option lvm est désactivée, le nœud n’a pas de LVM, ou l’utilisateur détient Sys.Audit sur /nodes seulement — cet inventaire le demande sur /. |
| La section Ceph manque tandis que le cluster a Ceph | ceph ou ceph_detail est désactivé, ou chaque nœud a répondu aux appels de détail avec une erreur. available: false sur /api/targets/{id}/proxmox/ceph signifie « pas de Ceph ici », pas « pas encore collecté ». |
| Aucun système d’exploitation ou adresse IP pour une VM | L’agent invité QEMU n’est pas activé ou pas installé dans cette VM, ou le jeton manque VM.GuestAgent.Audit sur Proxmox VE 8 (étape 7). Les conteneurs n’ont besoin d’aucun agent. Un invité qui vient de démarrer attend jusqu’à une heure : les faits sont rafraîchis chaque heure, pas à chaque sonde. |
| Un invité garde un badge de verrou | Une sauvegarde, migration ou snapshot interrompu l’a laissé. qm unlock <vmid> pour une VM, pct unlock <vmid> pour un conteneur — après avoir vérifié que la tâche est vraiment terminée. |
pve_backup_excludes_disk se déclenche sur une machine avec un CD-ROM | Non : lecteurs, images cloudinit et entrées qui ne sont pas des volumes sont exclus par conception et jamais rapportés par invité. Ce qui s’est déclenché est un vrai disque portant backup=0. |
Aucune série *_rrd_* | metrics_export est désactivé (c’est le défaut), ou l’utilisateur manque Sys.Audit sur /. |