
Proxmox VE
Hypervisor: nodi con i loro daemon e networking, macchine virtuali, contenitori, storage, pool thin LVM, backup, alta disponibilità, snapshot, replica, Ceph fino all’OSD, dischi fisici e pool ZFS, aggiornamenti in sospeso, modifiche ai pacchetti, subscription e certificati. Un monitor può coprire un intero cluster.
Il pannello dei nodi
Sezione intitolata “Il pannello dei nodi”La pagina del monitor si apre su una scheda per nodo: CPU, memoria e file system
radice come tre misuratori, il tempo di attività e la versione pve-manager installata
su quel nodo, poi solo ciò che non va — i daemon che non sono in esecuzione, le interfacce
dichiarate all’avvio che non sono su — e il riempimento di ogni pool thin LVM e volume group.
Un nodo che ha smesso di rispondere mantiene la sua scheda e legge offline.
Due righe sotto i misuratori, quando il nodo li segnala: la quota di tempo CPU trascorso in attesa dello storage (I/O wait — un nodo al 10% CPU e 30% I/O wait non ha spazio di manovra, e nessun altro numero lo dice) e la memoria KSM ha recuperato condividendo pagine identiche tra gli ospiti, che è come un nodo ospita più della sua RAM.
Due altre voci si uniscono all’elenco “cosa non va”, entrambe a parole:
- Riavvio richiesto — è installato un kernel più recente di quello in esecuzione. La
scheda nomina entrambe le versioni, poiché il nodo continua a eseguire quella vecchia finché non
viene riavviato. Ciò proviene da
/nodes/{node}/apt/versions, che ha bisogno solo diSys.Audit; - Aggiornamenti in sospeso — quanti pacchetti Proxmox hanno una versione candidata più recente,
dalla stessa chiamata. Non è la stessa cosa di
apt/update, che conta ogni pacchetto in sospeso del sistema ma ha bisogno diSys.Modifyed è solitamente rifiutato.
Quando il cluster segnala un watchdog HA (Proxmox VE 9 e successivi), il suo stato è dichiarato accanto al titolo del pannello: HA fencing armato una volta che le risorse vengono consegnate a HA, HA fencing standby mentre nessuna lo è — nel qual caso nessun nodo verrà recintato, che è normale ma vale la pena sapere prima di contare su di esso.
Un cluster aggiornato nodo per nodo lo mostra qui: /version risponde per il nodo
che è stato chiesto, quindi ogni scheda porta la sua versione e un ritardatario è
visibile senza aprire una shell.
I dati provengono da GET /api/targets/{id}/proxmox/nodes, letti dall’ultima
sonda nell’archivio delle metriche.
Il pannello ospiti
Sezione intitolata “Il pannello ospiti”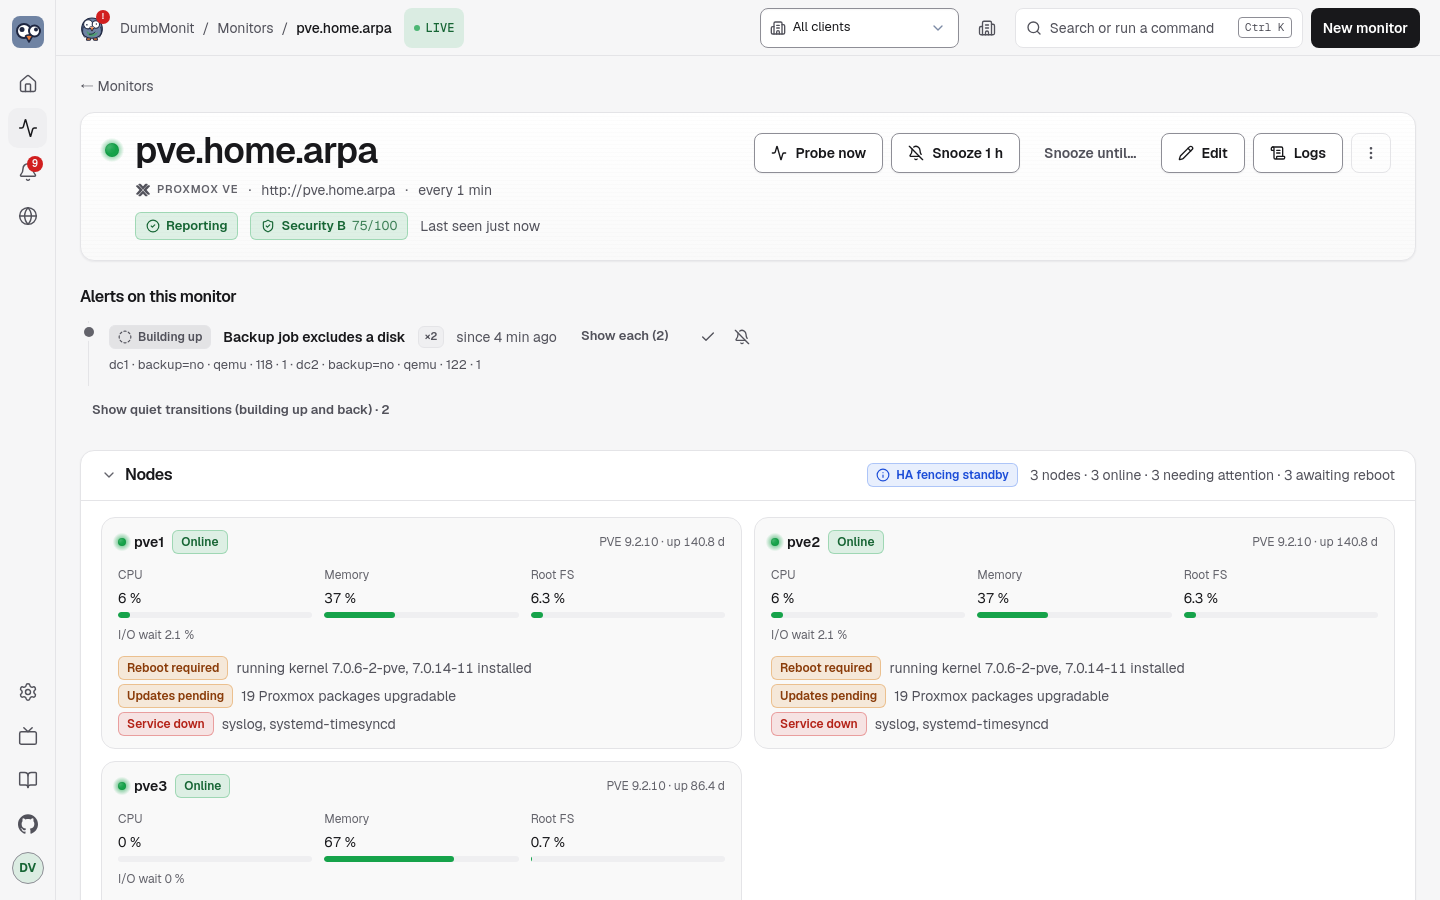
Sotto i nodi, il pannello Ospiti: una riga per macchina virtuale e contenitore, raggruppato per nodo, che risponde alle domande che un amministratore chiede per primo — sta funzionando, è occupato, il suo disco è pieno, quando è stato eseguito il suo backup per l’ultima volta. Ogni riga mostra:
| Colonna | Fonte | Note |
|---|---|---|
| Stato | parola + badge: in esecuzione, fermato, in pausa, sospeso, modello | Un modello è elencato ma non conta mai come “fermato”. |
| Nome, VMID, nodo | l’inventario | |
| CPU | guest_cpu_percent, dei core allocati al guest | Una barra più il numero di core. |
| Memoria | guest_memory_used_bytes / guest_memory_total_bytes | La dimensione del pallone quando la VM ne ha uno. Una seconda riga, +N sull’host, appare quando guest_memory_host_bytes è significativamente superiore a quello che il guest vede: un processo QEMU costa all’hypervisor più della memoria che consegna, e quel surplus è l’overhead di emulazione. Sotto 64 MiB o 5% la riga rimane fuori. |
| Disco | guest_disk_used_bytes / guest_disk_total_bytes | Contenitori: utilizzo reale. VM: la dimensione è sempre; l’utilizzo solo quando l’agente guest QEMU risponde (vedi sotto), altrimenti “solo dimensione”. |
| Rete | rate(guest_network_in/out_bytes) sulle ultime sonde | |
| Uptime | guest_uptime_seconds | |
| Ultimo backup | backup_last_age_seconds | Vuoto quando nessun backup è noto. |
| HA | ha_resource_state_info | Solo per gli ospiti sotto alta disponibilità. |
| Lock | guest_locked | Un badge, solo mentre un lock è mantenuto (backup, migrate, snapshot…). |
L’elenco ordina per qualsiasi colonna, filtra per nodo, stato o pool, e ogni gruppo di nodi si piega. Fare clic su una riga apre il suo CPU e la memoria sul time range della pagina, insieme al sistema operativo e agli indirizzi IP visti da dentro il guest. I dati provengono da GET /api/targets/{id}/proxmox/guests, che legge l’ultima sonda dall’archivio delle metriche — niente viene chiesto all’hypervisor.
Un lock è normale per i pochi minuti che un backup, una migrazione o uno snapshot impiega. Lasciato indietro da un lavoro interrotto, blocca ogni operazione su quel guest — incluso il backup della notte successiva — fino a quando qm unlock (o pct unlock) lo cancella, che è il motivo per cui “Guest locked” si attiva dopo sei ore.
L’inventario proviene da /cluster/resources, la cache del cluster, quindi i guest di un nodo che ha smesso di rispondere vengono ancora elencati — con lo stato
unknown e le loro dimensioni, senza misurazioni live — invece di scomparire
dal pannello al momento in cui vuoi guardarli. Risparmia anche due chiamate API
per nodo rispetto a percorrere /nodes/{node}/qemu e /nodes/{node}/lxc,
che è a cosa ricade l’opzione cluster_resources quando è disattivata.
Utilizzo del disco all’interno di una VM: l’agente guest QEMU
Sezione intitolata “Utilizzo del disco all’interno di una VM: l’agente guest QEMU”Proxmox vede il disco di una VM come un volume opaco: disk è sempre 0 per una VM,
solo la sua dimensione è nota. Per leggere l’utilizzo da dentro, il raccoglitore chiede l’agente
guest QEMU (agent/get-fsinfo) per ogni VM in esecuzione la cui configurazione
abilita l’agente (Opzioni → QEMU Guest Agent). Due condizioni:
qemu-guest-agentinstallato e in esecuzione all’interno della VM (Debian e Ubuntu:apt install qemu-guest-agent; Windows: l’ISO dei driver VirtIO);- il token contiene
VM.GuestAgent.Auditsulla VM —VM.Monitorprima di Proxmox VE 9 (il ruoloDumbMonitdi seguito lo concede su/).
Il file system radice (/, o C:\ su Windows; fallendo, quello più grande)
fornisce guest_disk_used_bytes e guest_disk_used_percent, la stessa serie che
un contenitore ha, quindi la regola “disco VM o contenitore quasi pieno” copre entrambi.
Ogni vero file system ottiene anche guest_fs_total/used_bytes e
guest_fs_used_percent con un’etichetta mountpoint; i pseudo file system (tmpfs,
squashfs, snap mounts) e i media senza capacità vengono saltati.
guest_agent_enabled dice se la configurazione della VM abilita l’agente,
guest_agent_running se ha risposto. Senza l’agente o il diritto, la
VM mantiene la sua dimensione e semplicemente non ha utilizzo — mai una figura fuorviante “0%”.
Il sistema operativo e gli indirizzi di un guest
Sezione intitolata “Il sistema operativo e gli indirizzi di un guest”Proxmox conosce solo il tipo di OS scritto nella configurazione di un guest (l26,
win11), non quello che realmente funziona. Con l’opzione guest_os attiva, il raccoglitore
chiede a ogni guest in esecuzione cosa sia: agent/get-osinfo e
agent/network-get-interfaces per una VM, /nodes/{node}/lxc/{vmid}/interfaces
per un contenitore, che non ha bisogno di niente installato dentro. Ciò fornisce
guest_os_info (Debian GNU/Linux 12 (bookworm), il suo id, la sua versione, il kernel)
e fino a quattro guest_ip_info — gli indirizzi loopback e IPv6 link-local vengono saltati,
e una macchina con dozzine di interfacce virtuali non riempie l’archivio delle serie.
Entrambi vengono chiesti al massimo una volta all’ora per guest e ripubblicati dalla memoria in seguito: un sistema operativo non cambia tra due sonde, e un indirizzo quasi mai lo fa. Su un cluster di cinquanta macchine in esecuzione, questa è la differenza tra due chiamate extra per sonda e due per ora.
Queste due chiamate dell’agente hanno bisogno di VM.GuestAgent.Audit. Proxmox VE 7 non ce l’aveva
e usava VM.Monitor; Proxmox VE 9 ha rimosso VM.Monitor e mantiene solo i
privilegi dell’agente guest. Senza quello che la tua versione conosce, le due serie sono
semplicemente assenti; nient’altro cambia.
Il pannello Ceph
Sezione intitolata “Il pannello Ceph”Una sezione Ceph appare sulla pagina del monitor solo quando il cluster effettivamente ha Ceph: salute e le parole dietro, capacità totale e usata, quanti OSD sono up e in, una tabella di OSD (host, classe di dispositivo, utilizzo, latenza di applica e commit) e una tabella di pool (utilizzo, dimensione e min size, gruppi di posizionamento rispetto al numero che l’autoscaler sceglierebbe), i file system CephFS, i flag OSD lasciati impostati e i controlli sanitari attualmente silenziati.
Gli ultimi due sono quelli che una dashboard solitamente nasconde. noout impostato per una
manutenzione e mai cancellato significa che Ceph non ribilancerà fuori un OSD morto
di nuovo, e un controllo silenziato non appare più in HEALTH_OK — in entrambi i casi il
cluster sembra sano mentre la sua ridondanza scompare silenziosamente.
GET /api/targets/{id}/proxmox/ceph risponde available: false quando il
cluster non ha Ceph, che è come l’UI sa di non disegnare la sezione affatto.
Il dettaglio costa tre chiamate su un singolo nodo più due a livello di cluster, qualunque sia la
dimensione del cluster, e ha bisogno dell’opzione ceph_detail in cima a ceph.
Cosa monitora
Sezione intitolata “Cosa monitora”Tutte le metriche hanno il prefisso dumbmonit_proxmox_.
| Famiglia | Metriche | Etichette |
|---|---|---|
| Cluster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online; version_info (+ version, release, repoid) | cluster, node |
| Inventario cluster | cluster_guests_total, cluster_guests_running, cluster_templates_total (modelli contati separatamente, mai come “fermato”); pool_guests, uno per pool di risorse | pool |
| Nodi | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (tempo trascorso in attesa di dischi — un nodo al 10% CPU e 30% iowait non ha spazio), node_ksm_shared_bytes (memoria recuperata dalla deduplicazione delle pagine), node_uptime_seconds, node_version_info | node |
| Servizi nodo | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down; node_pve_version_info (+ version, release) per il nodo che ha risposto | node, service |
| Rete nodo | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline; totale node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth…) |
| LVM, pool thin e mount | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (etichetta vg); node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (etichette vg, pool); node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Guest (VM e contenitori) | guest_status_info (+ status: running, stopped, paused, suspended, template), guest_running (non per modelli), guest_cpu_percent (dei core allocati), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9: la memoria che la VM occupa sull’host, overhead di emulazione incluso), guest_memory_percent (dal punto di vista del guest; su Proxmox VE 9 viene dal driver del pallone, e una VM senza uno ha byte ma nessuna percentuale piuttosto che una figura sopra il 100%), guest_disk_total_bytes, guest_disk_used_bytes e guest_disk_used_percent (contenitori; VM solo attraverso l’agente guest), guest_disk_read/write_bytes, guest_network_in/out_bytes (contatori), guest_uptime_seconds; guest_pool_info (+ pool), guest_locked (+ lock; la serie esiste solo mentre il lock è mantenuto, così la sua durata si legge dritto dal grafico) | node, vmid, name, type (qemu o lxc) |
| Dettaglio VM (VM in esecuzione) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (memoria libera vista da dentro, driver pallone), guest_running_qemu_info (+ version: il QEMU con cui è stata avviata la VM — dopo un aggiornamento dell’hypervisor rimane indietro finché la VM non viene fermata e riavviata di nuovo, cosa che una migrazione live non fa); per file system guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type; file system: + mountpoint, fstype |
| Sistema guest e indirizzi | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip; al massimo quattro indirizzi instradabili per guest). Aggiornato una volta all’ora | node, vmid, name, type |
| Schede di rete guest | guest_netdev_in_bytes, guest_netdev_out_bytes (contatori), una coppia per interfaccia virtuale dove guest_network_in/out_bytes dà solo il totale del guest | node, vmid, dev (tap100i0, veth200i0) |
| Storage | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (la capacità viene pubblicata solo quando Proxmox la segnala: uno storage inattivo, o un datastore PBS la cui dimensione PVE non legge, ottiene nessuno piuttosto che zero byte) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs…), shared |
| Backup (per guest) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count; totali backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Backup (esecuzioni vzdump, per nodo) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Lavori di backup (programmati) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (gli ultimi due solo quando un’attività vzdump porta l’id del lavoro, PVE 7.2+); totali backup_jobs_total, backup_guests_not_covered; backup_covered per guest (0 per un guest che nessun lavoro copre) | job, storage, schedule; backup_covered: vmid, name, node, type |
| Copertura del lavoro di backup | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), pubblicato solo per un’esclusione inaspettata | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state: Proxmox VE 9 segnala se il watchdog è armed o su standby — su standby niente verrà recintato), ha_master_active, ha_lrm_active (node), ha_resources_total; per risorsa ha_resource_started, ha_resource_error (1 nello stato error, fence o recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| Manager HA | ha_node_online, ha_node_status_info (+ status: online, fence, gone, maintenance), ha_master_info (il nodo che tiene il master CRM), ha_manager_age_seconds; per nodo ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1 quando l’LRM non ha scritto per più di due minuti) | node |
| Snapshot | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (le età solo quando count > 0); guest_snapshot_guests_skipped quando max_snapshot_guests è superato | vmid, name, node, type |
| Replica | replication_job_enabled, replication_job_error (messaggio di errore o fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds; replication_jobs_total | job, vmid, node (source), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 unknown), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| OSD Ceph | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight; totali ceph_osds_down, ceph_osds_out | osd, ceph_host, device_class |
| Pool Ceph e CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (quello che l’autoscaler sceglierebbe), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool; CephFS: name |
| Flag e silenzi Ceph | ceph_flag (1 mentre il flag è impostato), ceph_flags_set; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag; silenzi: code |
| Dischi fisici | node_disk_size_bytes, node_disk_smart_failed (1 quando la salute SMART è FAILED; assente quando il disco segnala UNKNOWN), node_disk_health_info (+ health, used: LVM, ZFS, partitions…), node_disk_wearout_percent (SSD e NVMe: 0 nuovo, 100 fine della vita nominale), node_disk_temperature_celsius (da disks/smart: attributo ATA 194/190, o la riga di temperatura di un rapporto di testo — Temperature: per NVMe, Current Drive Temperature: per SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| Pool ZFS | node_zfs_pool_degraded (1 a meno che non sia ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Aggiornamenti | node_updates_pending, node_updates_security_pending (pacchetti la cui origine, etichetta repository, suite, sezione o URL changelog nomina un archivio di sicurezza, come bookworm-security di Debian). Senza Sys.Modify questi due non esistono; node_pve_packages_upgradable conta comunque i pacchetti Proxmox la cui versione candidata differisce da quella installata, e node_reboot_required (+ running, installed) dice che è installato un kernel più recente ma non ancora avviato — entrambi legati da apt/versions, che ha bisogno solo di Sys.Audit | node |
| Modifiche ai pacchetti | node_packages_changed: 0 normalmente; per un’ora dopo che una sonda vede la versione installata di un pacchetto Proxmox cambiare (apt/versions), il numero di pacchetti che hanno cambiato, con un’etichetta changes come pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Subscription e repository | node_subscription_active, node_subscription_info (+ status: active, notfound, expired…, level, next_due); node_repository_errors (file di sorgenti illeggibili), node_repository_warnings (avvisi di Proxmox: repository aziendale senza subscription, repository di test), node_repository_enabled (+ repo: enterprise, no-subscription, test, ceph-*) | node |
| Certificati | node_certificate_expiry_days (negativo una volta scaduto) | node, filename, subject |
| Flusso RRD (disattivato per impostazione predefinita) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — ogni misura che i server di metriche di Proxmox ricevono, con il suo nome (vedi metrics_export di seguito) | node; guest: vmid, type; storage: node, storage |
| Raccolta | up, scrape_errors, scrape_duration_seconds |
L’età del backup per macchina risponde al fallimento più costoso di un homelab: il
backup che non viene eseguito per settimane, scoperto il giorno del ripristino. Viene calcolato
dal log dell’attività vzdump (su backup_lookback_days) e, se
scan_backup_storage è acceso, dagli archivi trovati sugli storage di backup.
I lavori programmati provengono da Datacenter → Backup: backup_covered è 0 per ogni
guest che Proxmox stesso elenca come non coperto da nessun lavoro, quindi una macchina creata
ieri mostra prima del suo primo backup mancato piuttosto che dopo.
Un lavoro che copre un guest non scrive necessariamente tutti i suoi dischi. Un volume
segnato backup=0 viene saltato ogni notte, il lavoro segnala comunque successo,
e nessuno scopre fino a un ripristino. backup_job_guest_excluded_volumes nomina
il lavoro, il guest e il motivo proprio di Proxmox per l’esclusione — ma solo quando
l’esclusione è una sorpresa: un’unità CD-ROM, un’immagine cloudinit o una voce che
non è affatto un volume è esclusa per design, contata in
backup_job_volumes_excluded e mai segnalata per guest. Senza quella
distinzione ogni macchina con un drive virtuale solleverebbe un avviso.
I daemon di un nodo meritano di essere osservati per un motivo: pvestatd fermato non
rompe niente visibilmente — l’interfaccia web continua a mostrare i numeri dal
momento in cui è morto, e tutto sembra normale. node_core_services_down conta
solo pve-cluster, pvedaemon, pveproxy, pvestatd, pve-firewall,
corosync e watchdog-mux, e solo quelli che il nodo stesso dichiara come
abilitati, quindi un nodo standalone senza corosync o HA non conta niente mancante.
Un’interfaccia conta come offline quando è impostata per avviarsi all’avvio e non è su (o non esiste più affatto). Una portata su richiesta, senza avvio automatico, è mai segnalata: la sua assenza è normale. Un bridge che non torna su dopo un riavvio taglia fuori ogni guest collegato ad esso mentre ognuno di quei guest funziona perfettamente, e nient’altro lo dice.
Un pool thin LVM che si riempie mette ogni guest memorizzato su di esso di sola lettura subito, e l’eliminazione di file all’interno degli ospiti non restituisce lo spazio. I loro metadati vivono sui loro, volume molto più piccolo e spesso satura per primo, con esattamente la stessa conseguenza — che è il motivo per cui i due livelli di riempimento sono serie separate e regole separate.
Le modifiche ai pacchetti vengono rilevate dal raccoglitore stesso: ricorda le versioni installate della sonda precedente (per monitor e nodo, in memoria — un riavvio del server impara di nuovo senza segnalare). Solo un pacchetto presente in entrambe le sonde con una versione diversa conta; un pacchetto appena installato o rimosso non lo fa.
Un fallimento parziale (un nodo giù, uno storage lento) è ancora una sonda riuscita:
quello che poteva essere letto è scritto e il fallimento è contato in scrape_errors.
Le funzioni che sono semplicemente assenti rimangono silenziose: no Ceph, no job di replica,
no pool ZFS, no agente guest, o no diritto di elencare aggiornamenti non producono serie e no
errore. Lo stesso vale per tutto quanto sopra: un privilegio mancante (403), un
endpoint che un Proxmox più vecchio non ha (404 o 501), una funzione che non è
installata (Ceph risponde 500) non produce errore e nessuna metrica affatto — mai
uno zero che finge di essere una misurazione.
Le temperature della board non sono disponibili: l’API di Proxmox VE non espone sensori, solo la temperatura SMART del disco. Installa l’agente DumbMonit sul nodo se ne hai bisogno di più.
Le regole incorporate che si applicano: Device irraggiungibile, CPU alta, Disco quasi pieno, File system quasi pieno (previsione), Backup troppo vecchio, CPU insolita, VM o contenitore fermato, CPU VM o contenitore alta, Memoria VM o contenitore alta, VM o contenitore disco quasi pieno, Risorsa HA in errore, Cluster ha perso il quorum, Nodo offline, Storage quasi pieno, Lavoro di backup fallito, Snapshot vecchio, Replica fallita, Errore di salute Ceph, Avvertenza di salute Ceph, Aggiornamenti in sospeso, Aggiornamenti di sicurezza in sospeso, Pacchetti Proxmox modificati, Disco Proxmox che si usura, Guasto SMART disco Proxmox, Pool ZFS Proxmox degradato, Certificato nodo in scadenza, Pool thin quasi pieno, Metadati pool thin quasi pieni, Servizio Proxmox giù, Interfaccia di rete nodo giù, OSD Ceph giù, OSD Ceph quasi pieno, Pool Ceph quasi pieno, Flag noout Ceph lasciato acceso, Manager HA non segnala, Lavoro di backup esclude un disco, Guest bloccato.
Il flusso RRD completo
Sezione intitolata “Il flusso RRD completo”/cluster/metrics/export è l’endpoint che i server di metriche di Proxmox
(InfluxDB, Graphite) consumano: tutto ciò che pvestatd misura, per l’intero
cluster, in una chiamata. Due cose lo rendono degno di avere.
- Porta misurazioni che nient’altro espone — in particolare il per-nodo informazioni sulla pressione stall (PSI): quanto tempo i task trascorrono in attesa della CPU, del disco o della memoria. Questo è il numero che spiega “tutto è lento” quando CPU e memoria entrambi sembrano buoni.
- Viene letto con
history=1dall’ultimo punto già visto, quindi ogni punto tra due sonde viene ingerito al suo timestamp proprio. Un monitor sondato ogni cinque minuti ottiene i suoi cinque punti uno-minuto invece di un singolo valore corrente.
È disattivato per impostazione predefinita, e questo è un compromesso deliberato. Quelle serie parzialmente
si ripetono quelli che il resto della raccolta produce già con nomi migliori, così
l’attivazione di metrics_export aggiunge un gran numero di serie da memorizzare e da setacciare
per il dettaglio che la maggior parte delle installazioni non guarda mai. I nomi vengono pubblicati
esattamente come Proxmox li invia (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin…) piuttosto che tradotti: Proxmox aggiunge nuovi ad ogni
release, e una tabella di traduzione scritta qui sarebbe sbagliata per il prossimo.
Ha bisogno di Sys.Audit su / — che il ruolo DumbMonit ha già quando è
stato concesso su / come di seguito.
Cosa preparare in Proxmox
Sezione intitolata “Cosa preparare in Proxmox”I passaggi di seguito sono quelli che l’avviso accanto al modulo mostra. Il principio: un utente riservato per il monitoraggio, un ruolo che può solo leggere, un token — mai l’account con cui accedi.
-
Apri una shell su qualsiasi nodo (nell’interfaccia web: seleziona il nodo, quindi Shell; o SSH) e crea un utente riservato per il monitoraggio. Non ha bisogno di una password: il token è quello che accede.
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
Crea un ruolo con solo i privilegi che usa il raccoglitore: Sys.Audit (nodi, cluster, HA, dischi e SMART, ZFS, certificati, versioni dei pacchetti, subscription), Datastore.Audit (storage e archivi di backup), VM.Audit (VM, contenitori, snapshot) e VM.GuestAgent.Audit (quello che l’agente guest QEMU legge all’interno di una VM: utilizzo del disco, sistema operativo, indirizzi IP). Nessuno di loro può cambiare niente.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
Dai all’utente quel ruolo su l’intero cluster.
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
Crea il token API dell’utente. La separazione dei privilegi è disattivata, quindi il token semplicemente eredita i diritti dell’utente.
pveum user token add dumbmonit@pve monitor --privsep 0 -
Il comando stampa una tabella con full-tokenid e value. Copia full-tokenid nel campo Token ID di DumbMonit e value (l’UUID) nel suo campo Secret. Il segreto viene mostrato una volta: se viene perso, rimuovi il token e creane uno nuovo.
dumbmonit@pve!monitor -
Facoltativo, per contare gli aggiornamenti in sospeso e le correzioni di sicurezza in sospeso: Proxmox protegge quell’elenco con Sys.Modify. Concedilo su /nodes solo; senza di esso il raccoglitore salta l’elenco silenziosamente.
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
Su un Proxmox più vecchio, VM.GuestAgent.Audit potrebbe non esistere ancora e il comando sopra viene rifiutato con privilegio non valido: le chiamate dell’agente guest sono allora coperte da VM.Monitor, che Proxmox VE 9 ha rimosso a sua volta. Usa quale la tua versione conosce.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
Preferisci l’interfaccia web? Gli stessi passaggi vivono in Datacenter → Permissions: Users, Roles, Add → User Permission, quindi API Tokens con “Privilege Separation” deselezionato.
-
In DumbMonit, inserisci l’indirizzo di qualsiasi nodo (porta 8006 per impostazione predefinita).
Documentazione fornitore: Gestione dell’utente Proxmox VE.
Credenziali
Sezione intitolata “Credenziali”| Credenziale | Campi |
|---|---|
| Token API (consigliato) | Token ID: utente, realm e nome del token come Proxmox li mostra, dumbmonit@pve!monitor. Secret: l’UUID mostrato una volta quando il token è stato creato. Nessuna scadenza, nessuna sessione aperta sull’hypervisor. |
| Nome utente / password | user@realm e la password. Un biglietto viene ottenuto, memorizzato nella cache e rinnovato dieci minuti prima della sua scadenza di due ore. |
L’API accetta il token in due pezzi (token_id + secret) o, come le versioni più vecchie facevano, come una stringa token = user@realm!name=secret; entrambi vengono memorizzati nello stesso modo. Un token intero incollato in Token ID è diviso dal modulo.
Il ruolo DumbMonit sopra porta quello che PVEAuditor concede per i percorsi che il
raccoglitore legge, più il privilegio dell’agente guest: il raccoglitore solo mai fa GET. Per endpoint: Sys.Audit per /version, /cluster/*, /nodes/{node}/status,
services, version, network, netstat, tasks, replication,
certificates/info, disks/list, disks/smart, disks/zfs, apt/versions,
apt/repositories e subscription; Datastore.Audit per storage e
storage/{id}/content; VM.Audit per qemu, lxc, snapshot,
status/current e le interfaces di un contenitore; VM.GuestAgent.Audit — o
VM.Monitor prima di Proxmox VE 9 — per agent/get-fsinfo.
Due percorsi chiedono un po’ più del resto, e entrambi sono coperti dal ruolo
come concesso al passaggio 3 — su /, non su /nodes:
Sys.Auditsu/per l’inventario LVM (disks/lvm,disks/lvmthin,disks/directory) e per/cluster/metrics/export, il flusso RRD facoltativo. Concesso solo su/nodes, la serie thin-pool e le serie*_rrd_*sono silenziosamente assenti.VM.GuestAgent.Auditper le due chiamate dell’agente guest che leggono il sistema operativo di una VM e gli indirizzi (agent/get-osinfo,agent/network-get-interfaces). Proxmox VE 7 non aveva quel privilegio e usavaVM.Monitor; Proxmox VE 9 ha rilasciatoVM.Monitor. Senza quello che la tua versione conosce,guest_os_infoeguest_ip_infosono semplicemente non pubblicati per le VM; i contenitori, che non hanno bisogno dell’agente, mantengono i loro indirizzi.
L’unica cosa che il ruolo non copre affatto è l’elenco degli aggiornamenti in sospeso
(apt/update), che Proxmox protegge con Sys.Modify su /nodes — facoltativo,
come il passaggio 6 spiega; senza di esso il raccoglitore salta node_updates_pending e
node_updates_security_pending silenziosamente.
(Usa -token 'dumbmonit@pve!monitor' invece di -user nei comandi aclmod
per un token creato con “Privilege Separation” spuntato.)
Indirizzo: 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] o un URL completo
https://pve.example.net. Lo schema https e la porta 8006 vengono aggiunti se
mancanti.
Opzioni
Sezione intitolata “Opzioni”| Chiave | Etichetta | Predefinito | Aiuto |
|---|---|---|---|
port | Porta API | 8006 | Usato se l’indirizzo non dà una porta. |
insecure_tls | Accetta un certificato non verificabile | false | Proxmox viene fornito con un certificato autofirmato per impostazione predefinita: abilita questo se la connessione viene rifiutata per quel motivo. |
request_timeout_seconds | Timeout per richiesta (secondi) | 10 | Tempo consentito per ogni chiamata API, da 1 a 120. |
backup_lookback_days | Lookback backup (giorni) | 31 | I task di backup più vecchi non vengono esaminati, da 1 a 3650. |
scan_backup_storage | Inventario archivi di backup | true | Scansiona gli storage di backup per datare il backup più recente di ogni macchina. Disabilita se lo storage è lento a rispondere. |
nodes | Nodi monitorati | (empty) | Nomi dei nodi da monitorare, separati da virgole. Vuoto: ogni nodo nel cluster. |
cluster_resources | Leggi l’inventario del cluster | true | Una chiamata a /cluster/resources elenca ogni nodo, guest, storage e pool. Mantienilo attivato: è l’unica fonte che vede ancora i guest di un nodo che ha smesso di rispondere, e salva due chiamate per nodo. Disattivato, il raccoglitore percorre /nodes/{node}/qemu e /nodes/{node}/lxc invece, e perde i pool e i lock. |
services | Osserva i servizi del nodo | true | /nodes/{node}/services e version: lo stato dei daemon Proxmox di ogni nodo e la versione installata su di esso. Un pvestatd fermato lascia l’intero cluster che mostra numeri congelati. |
network | Osserva il networking del nodo | true | /nodes/{node}/network e netstat: bridge, bond e VLAN con il loro stato di collegamento, più i contatori di traffico di ogni scheda di rete guest. |
lvm | Osserva LVM e pool thin | true | disks/lvm, disks/lvmthin e disks/directory: volume group, pool thin (dati e riempimento dei metadati) e mount di directory gestiti da PVE. Ha bisogno di Sys.Audit su /; silenzioso altrimenti. |
ha | Alta disponibilità | true | Legge /cluster/ha/status/current e manager_status: quorum, master CRM, la vista proprio del manager di ogni nodo, ogni LRM con l’età della sua ultima segnalazione, e ogni risorsa HA. |
backup_jobs | Lavori di backup programmati | true | Legge i lavori da Datacenter → Backup e i guest che nessun lavoro copre. |
scan_snapshots | Inventario snapshot | true | Una chiamata per guest (quattro in volo per nodo). Disabilita su cluster molto grandi. |
max_snapshot_guests | Limite inventario snapshot | 200 | I guest oltre questo numero vengono saltati ogni sonda e contati in guest_snapshot_guests_skipped, da 1 a 10000. |
replication | Lavori di replica | true | Stato di replica dello storage per nodo. Silenzioso quando il nodo non ha nessun lavoro. |
ceph | Salute Ceph | true | Legge /cluster/ceph/status. Silenzioso quando Ceph non è installato. |
ceph_detail | Osserva Ceph in dettaglio | true | Stato per-OSD, utilizzo e latenza, utilizzo per-pool, CephFS, flag OSD e controlli sanitari silenziati. Tre chiamate su un nodo più due a livello di cluster, indipendentemente dalla dimensione del cluster. Ha bisogno di ceph attivo; silenzioso senza Ceph. |
backup_volumes | Controlla cosa includono i lavori di backup | true | Per ogni lavoro programmato, quali guest copre e quali dei loro dischi scrive effettivamente. Rileva un lavoro che ha successo ogni notte mentre salta un disco di dati. Una chiamata per lavoro. |
guest_os | Leggi OS guest e indirizzi | true | Sistema operativo e indirizzi IP visti da dentro ogni guest in esecuzione (agente guest QEMU per VM, namespace del contenitore per contenitori). Aggiornato una volta all’ora per guest, non ad ogni sonda. Ha bisogno di VM.GuestAgent.Audit su Proxmox VE 8. |
metrics_export | Ingesta il flusso di metriche RRD completo | false | Legge /cluster/metrics/export, il flusso che i server di metriche di Proxmox consumano, inclusa la pressione stall per-nodo (PSI), e ogni punto dall’ultima sonda piuttosto che solo quella corrente. Disattivato per impostazione predefinita: le serie *_rrd_* che aggiunge parzialmente si ripetono quelle già raccolte. Ha bisogno di Sys.Audit su /. |
updates | Aggiornamenti in sospeso | true | Conta i pacchetti che apt/update elenca. Ha bisogno di Sys.Modify su /nodes (vedi sopra); silenzioso altrimenti. |
certificates | Scadenza certificato | true | Giorni rimasti su ogni certificato del nodo (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | Chiedi l’agente guest QEMU | true | Per ogni VM in esecuzione: status/current (pallone, flag agente) e, quando l’agente è abilitato, agent/get-fsinfo (ha bisogno di VM.GuestAgent.Audit). Quattro chiamate in volo per nodo. Silenzioso quando l’agente è assente. |
disks | Osserva i dischi fisici | true | disks/list più una chiamata disks/smart per disco: salute, usura, temperatura. |
zfs | Osserva i pool ZFS | true | disks/zfs: salute, capacità, frammentazione. Silenzioso senza ZFS. |
packages | Rileva modifiche ai pacchetti | true | apt/versions confrontato con la sonda precedente; un cambiamento viene segnalato per un’ora in node_packages_changed. |
subscription | Osserva subscription e repository | true | subscription e apt/repositories: stato, avvertimenti, repository standard abilitati. |
Errori comuni
Sezione intitolata “Errori comuni”| Sintomo | Causa probabile |
|---|---|
| Errore certificato mostrato sul monitor | Certificato autofirmato. O installa un certificato attendibile (ACME è incorporato in Proxmox) o abilita insecure_tls. L’opzione non è mai abilitata implicitamente. |
| Errore di autenticazione | Secret incollato in Token ID (o viceversa), “Privilege Separation” lasciato spuntato (il token allora non ha diritti), o il ruolo DumbMonit non applicato su /. |
| Backup age mancante per un guest | Nessun task vzdump nella finestra di lookback e nessun archivio trovato sugli storage; o scan_backup_storage disabilitato. |
| Sonde lente | Uno storage di backup che impiega a lungo per elencare, o molti guest per inventario per snapshot. Disabilita scan_backup_storage o scan_snapshots, abbassa max_snapshot_guests, o alza request_timeout_seconds. |
node_updates_pending mancante | L’utente o il token manca di Sys.Modify su /nodes. Concedi il ruolo DumbMonitUpdates del passaggio 6, o ignora: node_pve_packages_upgradable e node_reboot_required copre i pacchetti Proxmox senza di esso. |
| Nessuna percentuale di memoria per una VM | Proxmox VE 9 segnala, nell’inventario del cluster, la memoria che la VM occupa sull’host — overhead incluso, quindi regolarmente al di sopra della sua allocazione. Una percentuale calcolata da esso rimarrebbe al di sopra del 100% per sempre. La figura onesta viene dal driver del pallone all’interno del guest; una VM con bilanciamento disabilitato quindi mostra byte e nessuna percentuale. guest_memory_host_bytes è la figura sull’host. |
| Nessuna capacità per lo storage di backup | Un datastore Proxmox Backup Server montato su PVE non segnala dimensione: PVE non lo legge. La pagina del monitor del datastore stesso lo ha. |
| Utilizzo del disco vuoto (“solo dimensione”) per una VM | La VM non ha agente guest QEMU (non abilitato nelle sue opzioni, o qemu-guest-agent non installato dentro), o il token manca di VM.GuestAgent.Audit. guest_agent_enabled e guest_agent_running dicono quale. I contenitori non ne hanno mai bisogno. |
Nessuna serie node_disk_* | Il token manca di Sys.Audit su / (il ruolo DumbMonit lo concede), o il nodo esegue dietro un controller RAID che nasconde SMART: disks/list allora segnala UNKNOWN e nessun node_disk_smart_failed viene pubblicato. |
node_packages_changed si attiva dopo il riavvio di un server | Non lo fa: la prima sonda dopo un riavvio solo impara le versioni. Un cambiamento viene segnalato solo tra due sonde consecutive dello stesso processo di server. |
backup_job_last_ok{job=…} mancante mentre backup_job_last_ok{node=…} esiste | I task vzdump non portano l’id del lavoro (Proxmox VE più vecchio di 7.2, o lavori eseguiti a mano). Lo stato di esecuzione per-nodo è ancora lì. |
| Nessuna metrica Ceph o replica | Niente da segnalare: Ceph non è installato, o nessun lavoro di replica è configurato. Non è un errore. |
| Nessun pool thin o volume group su una scheda del nodo | L’opzione lvm è disattivata, il nodo non ha LVM, o l’utente tiene Sys.Audit su /nodes solo — quell’inventario lo chiede su /. |
| La sezione Ceph è mancante mentre il cluster ha Ceph | ceph o ceph_detail è disattivato, o ogni nodo ha risposto alle chiamate di dettaglio con un errore. available: false su /api/targets/{id}/proxmox/ceph significa “nessun Ceph qui”, non “non ancora raccolto”. |
| Nessun sistema operativo o indirizzo IP per una VM | L’agente guest QEMU non è abilitato o non è installato in quella VM, o il token manca di VM.GuestAgent.Audit su Proxmox VE 8 (passaggio 7). I contenitori non hanno bisogno dell’agente. Un guest appena avviato aspetta fino a un’ora: i fatti vengono aggiornati ogni ora, non ad ogni sonda. |
| Un guest mantiene un badge di lock | Un backup interrotto, migrazione o snapshot lo ha lasciato indietro. qm unlock <vmid> per una VM, pct unlock <vmid> per un contenitore — dopo aver controllato che il lavoro è veramente finito. |
pve_backup_excludes_disk si attiva su una macchina con un CD-ROM | Non lo fa: unità, immagini cloudinit e voci che non sono volumi sono escluse per design e mai segnalate per guest. Quello che si è attivato è un disco reale che porta backup=0. |
Nessuna serie *_rrd_* | metrics_export è disattivato (lo è per impostazione predefinita), o l’utente manca di Sys.Audit su /. |